目录
Milvus作为向量数据库中的热门选型之一,本篇文章带你了解下Milvus
从业务角度,Milvus数据模型层级如下
Database -> Collection -> Partition -> Entity
- Database:Milvus 的数据库,用来隔离不同业务数据。
- Collection:最核心的逻辑容器,类似于关系型数据库里的 table。
- Partition:分区,是 collection 的子集,不是必须手动创建;一个 collection 至少会有默认partition。
- Entity:可以理解为 collection 中的一条记录。类似于关系型数据库的一行数据。
1. DDL操作
1.1 Database
创建客户端
pythonfrom pymilvus import MilvusClient
client = MilvusClient("http://localhost:19530")
列出所有数据库
pythonexisted_databases = client.list_databases()

for db in existed_databases:
    print(db)
创建数据库
pythondb_name = "rag_demo"

if db_name not in existed_databases:
    client.create_database(db_name=db_name)
删除数据库
如果数据库下有Collection则无法删除,需要先删除它的所有Collection才能删除Database
pythonclient.drop_database(db_name=db_name)
切换数据库
pythonclient.use_database(db_name=db_name)
1.2 Collection
查看数据库下的collections
python
collections = client.list_collections()

for coll in collections:
    print(coll)
创建collection
pythoncollection_name = "docs"

client.create_collection(
    collection_name=collection_name,
    dimension=1024,
    metric_type="COSINE"
)
-
dimension :嵌入向量维度,应和嵌入模型的向量维度保持一致,见下文。
-
metric_type 表示向量相似度的计算方式, COSINE 表示余弦相似度。
当用户提问时,系统会把提问也变成向量,然后去数据库里找“最相似”的本地文本向量。但怎么定 义“相似”呢? 向量数据库需要知道计算规则。 COSINE (余弦相似度)关注的是两个向量在方向上的夹角:
- 如果两个向量方向完全一致(代表文本意思极度接近),余弦值接近 1 。
- 如果方向正交(毫无关系),值接近 0 。
- 结论:在 RAG 检索时,Milvus 会帮你计算用户问题与数据库中所有文本的余弦相似度,并把 得分(Score)从大到小排序,把得分最高(最相似)的前 K 个片段还给你。 (注:除了COSINE 之外,常见的还有 L2 欧氏距离、 IP 内积等。)
删除collection
pythonclient.drop_collection(collection_name=collection_name)
2. DML操作
2.1 准备嵌入模型
pythonimport os

# HF国内镜像
os.environ["HF_ENDPOINT"] = "https://hf-mirror.com"
# 防止CPU多线程死锁
os.environ["OMP_NUM_THREADS"] = "1"
os.environ["MKL_NUM_THREADS"] = "1"
from typing import List

import torch
from dotenv import load_dotenv
from langchain_core.embeddings import Embeddings
from pydantic import BaseModel, PrivateAttr
from transformers import AutoTokenizer, AutoModel

load_dotenv(override=True)


class BGESentenceEmbedding(BaseModel, Embeddings):
   model_name: str
   cache_dir: str
   device: str = "cpu"

   # ✅ PrivateAttr:实例私有变量,不参与pydantic校验,完美解决冲突
   _tokenizer: AutoTokenizer = PrivateAttr()
   _model: AutoModel = PrivateAttr()

   def __init__(self, **kwargs):
       super().__init__(**kwargs)
       print("开始加载tokenizer...")
       self._tokenizer = AutoTokenizer.from_pretrained(
           self.model_name,
           cache_dir=self.cache_dir
       )
       print("开始加载model...")
       self._model = AutoModel.from_pretrained(
           self.model_name,
           cache_dir=self.cache_dir
       ).to(self.device)
       self._model.eval()
       print("✅ 模型加载完毕!")

   @staticmethod
   def _mean_pooling(model_output, attention_mask):
       token_embeddings = model_output[0]
       input_mask = attention_mask.unsqueeze(-1).expand(token_embeddings.size()).float()
       return torch.sum(token_embeddings * input_mask, 1) / torch.clamp(input_mask.sum(1), min=1e-9)

   def embed_query(self, text: str) -> List[float]:
       encoded = self._tokenizer(
           text, padding=True, truncation=True, return_tensors="pt"
       ).to(self.device)
       with torch.no_grad():
           model_output = self._model(**encoded)
       embeddings = self._mean_pooling(model_output, encoded["attention_mask"])
       embeddings = torch.nn.functional.normalize(embeddings, p=2, dim=1)
       return embeddings[0].cpu().tolist()

   def embed_documents(self, texts: List[str]) -> List[List[float]]:
       return [self.embed_query(t) for t in texts]


cache_path = os.path.join(os.getcwd(), "../embeddings")
embedding_model = BGESentenceEmbedding(
   model_name="BAAI/bge-base-zh-v1.5",
   cache_dir=cache_path,
   device="cpu"
)
2.2 准备collection
创建collection
pythoncollection_name = "docs"

client.create_collection(
   collection_name=collection_name,
   dimension=768,
   metric_type="COSINE"
)
BAAI/bge-base-zh-v1.5的维度是768,要和嵌入模型的保持一致,不然在数据存入时会报错
查看collection元数据,
python
from rich import print as rprint

metadata = client.describe_collection(collection_name=collection_name)

rprint(metadata)
 我们在创建collection时没有指定schema,后者可以理解为表结构,此时Milvus会将collection定义为默认结构。字段信息如下
- id :数据ID,作为主键唯一标识数据
- vector :数据的嵌入向量
此外, enable_dynamic_field 为 True ,这表示 collection 支持动态字段。也就是说,除了预定义的id 和 vector 字段之外,在插入数据时还可以携带其他未提前声明的字段,这些字段会被自动写入并 统一存储在动态字段 中。这样做的好处是能够在不修改 schema 的情况下,灵活保存额外的业务属性,例如文本内容、标签、时间戳或来源信息等,适合字段结构不固定的场景。
2.3 准备数据
python# 准备测试数据
texts = [
    "LangChain 是一个用于构建 LLM 应用的开发框架。",
    "Milvus 是一个适合 AI 应用的向量数据库。",
    "RAG 的核心是先检索相关知识,再让大模型生成答案。",
    "Docker Desktop 可以方便地在本地运行 Milvus Standalone。"
]

# 生成嵌入向量
vectors = embedding_model.embed_documents(texts)

# 封装可以存到milvus的数据
data = [
    {
        "id": i,
        "vector": vectors[i],
        "text": texts[i],
        "source": "demo"
    } for i in range(len(texts))
]
2.4 写入数据
python
insert_res = client.upsert(
    collection_name=collection_name,
    data=data,
)

print("insert result : ", insert_res)
# insert result :  {'upsert_count': 4, 'ids': [0, 1, 2, 3]}
upsert可以保证幂等写入,即主键相同时覆盖
手动flush
pythonclient.flush(collection_name=collection_name)
Milvus不会第一时间将数据落盘,要看到写入效果,我们手动flush,将数据刷写到磁盘
查看collection统计信息
pythonstats = client.get_collection_stats(collection_name=collection_name)

print("stats : ", stats)
3. DQL操作
3.1 扫描数据
pythoniterator = client.query_iterator(
    collection_name=collection_name,
    filter="",
    output_fields=["*"]
)

i = 0
while True:

    rows = iterator.next()

    if not rows:
        break

    for row in rows:
        print(f"第{i + 1}条数据:\n")

        print(f'id : {row["id"]},vector = {row["vector"][:5]},text = {row["text"]},source = {row["source"]}')

        #i += 1

iterator.close()
3.2 通过主键查询数据
pythonres = client.get(
    collection_name=collection_name,
    ids=[0, 1, 2]
)

print(len(res))

for i in range(len(res)):
    print(f"第{i + 1}条数据:")
    print(f'id : {res[i]["id"]},vector = {res[i]["vector"][:5]},text = {res[i]["text"]},source = {res[i]["source"]}')
    # print(res[i])
3.3 相似度检索
python# 相似度检索
query = "什么是向量数据库?"
query_vector = embedding_model.embed_query(query)

results = client.search(
    collection_name=collection_name,
    data=[query_vector],
    limit=3,
    output_fields=["text", "source", "id"]
)

for res in results[0]:
    print(res)
检索结果如下:
python{'id': 1, 'distance': 0.6177977919578552, 'entity': {'id': 1, 'text': 'Milvus 是一个适合 AI 应用的向量数据库。', 'source': 'demo'}}
{'id': 0, 'distance': 0.46440669894218445, 'entity': {'id': 0, 'text': 'LangChain 是一个用于构建 LLM 应用的开发框架。', 'source': 'demo'}}
{'id': 3, 'distance': 0.3925101161003113, 'entity': {'id': 3, 'text': 'Docker Desktop 可以方便地在本地运行 Milvus Standalone。', 'source': 'demo'
索引
Milvus 索引分为三大类:稠密向量索引、稀疏向量索引、标量索引
1. 稠密向量索引(FLOAT_VECTOR,RAG 最常用)
| Index 类型 | 核心参数 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| FLAT | 无参数 | 100% 召回,暴力全扫描 | 极慢,全量计算 | 数据量 <1 万,评测基准 |
| HNSW | M, efConstruction | 召回高、查询延迟低 | 内存占用高,建索引慢 | 百万级,RAG 在线检索,首选 |
| HNSW_SQ | M, efConstruction | HNSW+8bit 量化,内存省约 1/3 | 召回轻微下降 | 内存紧张,想要 HNSW 速度 |
| HNSW_PQ | M, efConstruction, m, nbits | 内存大幅压缩 | 召回下降明显 | 海量向量,内存资源有限 |
| IVF_FLAT | nlist | 内存占用小,建索引快 | 召回略低于 HNSW | 千万级向量,中等 QPS |
| IVF_SQ8 | nlist | 8bit 量化,内存省 75% | 召回小幅下降 | 大数据,内存受限 |
| IVF_PQ | nlist, m, nbits | 极致压缩 | 召回损失大 | 亿级粗召回 |
| DiskANN | - | 向量放磁盘,突破内存限制 | 查询延迟更高 | 超大规模,内存放不下 |
HNSW 参数说明
M:图中每个节点最大连接数,推荐 16~32;M 越大召回越好,内存越高efConstruction:建图时搜索邻居的范围,推荐 200~300;越大建索引越慢,图质量越高- 查询时参数
ef(在 search params 里):查询时遍历邻居数量,推荐≥64;越大召回越高,延迟越高,不属于建索引参数
IVF 参数说明
nlist:聚类中心数量,推荐公式nlist ≈ 4*sqrt(N),N 是向量总数;一般 1024/2048- 查询参数
nprobe:检索时探查多少个聚类中心,search 时配置;nprobe 越大召回越高,速度越慢
2. 稀疏向量索引(SPARSE_FLOAT_VECTOR)
- SPARSE_INVERTED_INDEX:BM25 / Splade 稀疏向量专用
- metric_type:Milvus 内置 BM25 函数用
BM25;手动构造 Splade 稀疏向量用IP
3. 标量索引(过滤字段,group_by 字段推荐建)
表格
| 索引类型 | 适用字段 | 场景 |
|---|---|---|
| INVERTED | 高基数:VARCHAR、INT(doc_id、id) | group_by 字段、filter 频繁过滤,推荐 |
| BITMAP | 低基数:status、type(取值很少) | 枚举类字段 |
重点:
group_by_field="doc_id",给 doc_id 建立 INVERTED 标量索引,会显著提升 group_by 分组检索性能
AUTOINDEX(自动索引)
index_type="AUTOINDEX",Milvus 自动根据向量规模、维度选择合适索引;开发调试非常方便,生产建议显式指定索引类型。
metric_type
创建索引时指定的 metric_type,必须和 search /hybrid_search 里 search_params.metric_type 完全一致,否则直接报错。
不同向量类型(FLOAT_VECTOR / SPARSE_FLOAT_VECTOR / BINARY_VECTOR)支持的 metric 不一样,不能混用。
| metric_type | 向量类型 | 打分规则 | 值域 | 核心说明 & 适用场景 |
|---|---|---|---|---|
| COSINE | FLOAT_VECTOR | 越大越相似 | [-1, 1] | ✅ RAG 文本 Embedding 首选,衡量向量方向夹角,不关心向量长度;BGE/E5/text-embedding 推荐;建议 Embedding 输出做归一化 |
| IP(InnerProduct,内积) | FLOAT_VECTOR / SPARSE_FLOAT_VECTOR | 越大越相似 | (-∞,+∞) | 归一化向量时,IP 等价 COSINE;不归一化时同时考虑方向 + 模长;Splade 稀疏向量用 IP |
| L2 | FLOAT_VECTOR | 越小越相似 | [0,+∞) | 欧氏距离;衡量空间直线距离;图像原始特征、数值向量;文本 Embedding 几乎不用 |
| BM25 | SPARSE_FLOAT_VECTOR | 越大越相关 | [0,+∞) | Milvus 内置 BM25 Function 专用,自动从文本生成稀疏向量;不是传统向量相似度,是全文检索打分 |
| HAMMING | BINARY_VECTOR | 越小越相似 | [0, dim] | 二进制向量,计算不同 bit 数量,图片 hash 指纹 |
| JACCARD | BINARY_VECTOR | 越小越相似 | [0,1] | minhash 集合相似度 |
重点坑:Milvus 返回结果字段统一叫
distance,命名很容易混淆:
- COSINE / IP / BM25:
distance越大 = 越匹配- L2 / HAMMING / JACCARD:
distance越小 = 越匹配
稠密向量 支持:COSINE 余弦相似度、IP 内积、L2 欧氏距离
稀疏向量 支持:BM25、IP
高级搜索
过滤搜索
在Milvus中,过滤搜索根据应用过滤的阶段分为:标准过滤和迭代过滤。
- 标准过滤:先过滤再搜索,先找出所有符合标量条件的实体,然后只在诸葛范围进行相量相似度搜索。
- 迭代过滤:边搜索边过滤,反复进行向量搜索,每搜出一批,就逐一检查是否符合标量条件,值到满足limit要求的数量。
测试数据
pythonfrom pymilvus import MilvusClient

client = MilvusClient()

data = [
    {"id": 0, "vector": [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592], "color": "pink_8682", "likes": 165},
    {"id": 1, "vector": [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104], "color": "red_7025", "likes": 25},
    {"id": 2, "vector": [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, 0.7894058910881185, 0.20785793220625592], "color": "orange_6781", "likes": 764},
    {"id": 3, "vector": [0.3172005263489739, 0.9719044792798428, -0.36981146090600725, -0.4860894583077995, 0.95791889146345], "color": "pink_9298", "likes": 234},
    {"id": 4, "vector": [0.4452349528804562, -0.8757026943054742, 0.8220779437047674, 0.46406290649483184, 0.30337481143159106], "color": "red_4794", "likes": 122},
    {"id": 5, "vector": [0.985825131989184, -0.8144651566660419, 0.6299267002202009, 0.1206906911183383, -0.1446277761879955], "color": "yellow_4222", "likes": 12},
    {"id": 6, "vector": [0.8371977790571115, -0.015764369584852833, -0.31062937026679327, -0.562666951622192, -0.8984947637863987], "color": "red_9392", "likes": 58},
    {"id": 7, "vector": [-0.33445148015177995, -0.2567135004164067, 0.8987539745369246, 0.9402995886420709, 0.5378064918413052], "color": "grey_8510", "likes": 775},
    {"id": 8, "vector": [0.39524717779832685, 0.4000257286739164, -0.5890507376891594, -0.8650502298996872, -0.6140360785406336], "color": "white_9381", "likes": 876},
    {"id": 9, "vector": [0.5718280481994695, 0.24070317428066512, -0.3737913482606834, -0.06726932177492717, -0.6980531615588608], "color": "purple_4976", "likes": 765}
]

client.insert(
    collection_name="quick_setup",
    data=data
)
标准过滤
pythonquery_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]

res = client.search(
    collection_name="quick_setup",
    data=[query_vector],
    limit=5,
    filter='color like "red%" and likes > 50',
    output_fields=["color", "likes"]
)
query_vector
迭代过滤
pythonquery_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]

res = client.search(
    collection_name="quick_setup",
    data=[query_vector],
    limit=5,
    filter='color like "red%" and likes > 50',
    output_fields=["color", "likes"],
    search_params={
        "hints": "iterative_filter"
    }
)
范围搜索
执行范围搜索请求时,Milvus以ANN搜索结果中与查询向量最相似的向量为圆心,以搜索请求中指定的半径为圈半径,以range_filter为内圈半径,画出两个同心圆。所以相似度得分在这两个同心圆形成的环形区域内的向量都将被返回。
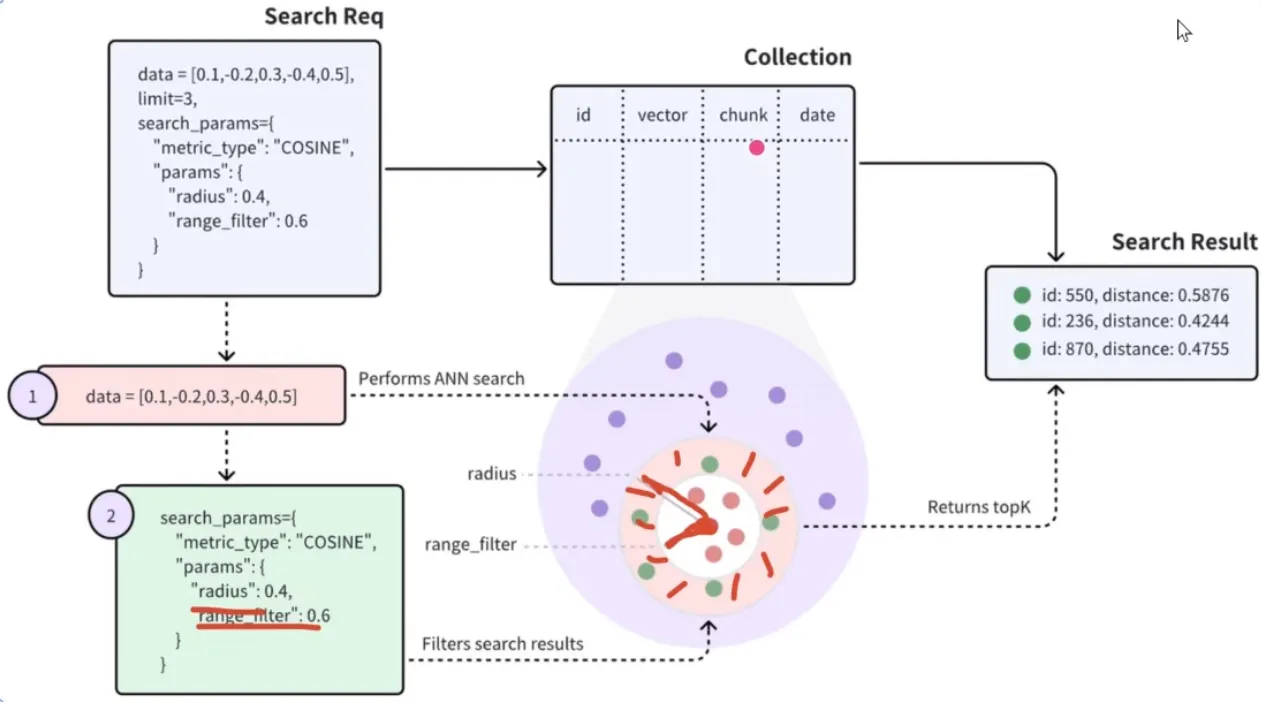
上图显示,范围搜索请求包含两个参数:半径和rang_filter。具体步骤:
- 使用指定的度量类型(COSINE)查找与查询向量最相似的所有向量嵌入。
- 过滤与查询向量的距离或得分在半径和range_filter参数范围内的向量嵌入。
- 从筛选出的实体返回前K个实体。
radius和range_filter因搜索的度量类型而异。
| 度量类型 | 名称 | 设置半径和范围筛选器的要求 |
|---|---|---|
| L2(欧式距离) | L2距离越小,相似度越高 | 要忽略最相似的向量embeddings,确保range_filter <= 距离 < radius |
| IP | IP距离越大,相似度越高 | 要忽略最相似的向量嵌入,确保 radius < 距离 <= range_filter |
| COSINE(余旋相似度) | COSINE距离越大,相似度越高 | 要忽略最相似的向量嵌入,确保 radius < 距离 <= range_filter |
| JACCARD | Jaccard距离越小,相似度越高 | 要忽略最相似的向量嵌入,确保range_filter <= 距离 < radius |
| HAMMING | 汉明距离越小,相似度越高 | 要忽略最相似的向量嵌入,确保range_filter <= 距离 < radius |
pythonres = client.search(
    collection_name="quick_setup",
    data=[query_vector],
    limit=3,
    search_params={
        "params": {
            "radius": 0.4,
            "range_filter": 0.6
        }
    }
)
分组搜索
RAG 场景最常用:chunk 向量检索,按
doc_id分组,每个文档只返回最相关的 1 条 / 多条 chunk,保证召回文档多样性,避免连续返回同一文档多个切片Milvus
参数说明
group_by_field:分组字段,必须是标量字段(int/varchar),不能是向量limit:最多返回多少个分组(不是返回多少条数据!默认每组返回 1 条)group_size:每组返回多少条记录,默认 = 1strict_group_size:布尔值False(默认):优先满足limit分组数量;组内不够数据就少返回,性能更好True:尽量填满每组group_size条;优先保证每组条数,可能返回少于 limit 的分组,开销更大
测试数据
pythondata = [
        {"id": 0, "vector": [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592], "chunk": "pink_8682", "docId": 1},
        {"id": 1, "vector": [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104], "chunk": "red_7025", "docId": 5},
        {"id": 2, "vector": [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, 0.7894058910881185, 0.20785793220625592], "chunk": "orange_6781", "docId": 2},
        {"id": 3, "vector": [0.3172005263489739, 0.9719044792798428, -0.36981146090600725, -0.4860894583077995, 0.95791889146345], "chunk": "pink_9298", "docId": 3},
        {"id": 4, "vector": [0.4452349528804562, -0.8757026943054742, 0.8220779437047674, 0.46406290649483184, 0.30337481143159106], "chunk": "red_4794", "docId": 3},
        {"id": 5, "vector": [0.985825131989184, -0.8144651566660419, 0.6299267002202009, 0.1206906911183383, -0.1446277761879955], "chunk": "yellow_4222", "docId": 4},
        {"id": 6, "vector": [0.8371977790571115, -0.015764369584852833, -0.31062937026679327, -0.562666951622192, -0.8984947637863987], "chunk": "red_9392", "docId": 1},
        {"id": 7, "vector": [-0.33445148015177995, -0.2567135004164067, 0.8987539745369246, 0.9402995886420709, 0.5378064918413052], "chunk": "grey_8510", "docId": 2},
        {"id": 8, "vector": [0.39524717779832685, 0.4000257286739164, -0.5890507376891594, -0.8650502298996872, -0.6140360785406336], "chunk": "white_9381", "docId": 5},
        {"id": 9, "vector": [0.5718280481994695, 0.24070317428066512, -0.3737913482606834, -0.06726932177492717, -0.6980531615588608], "chunk": "purple_4976", "docId": 3},
]
pythonquery_vectors = [
    [0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088]]

# Group search results
res = client.search(
    collection_name="my_collection",
    data=query_vectors,
    limit=3,
    group_by_field="docId",
    output_fields=["docId"]
)
主键向量检索
Primary Key Search(主键向量检索,Milvus >=2.6.9):传入主键,拿这条记录的向量去做相似检索(相似推荐),支持搭配 group_by_field
pythonclient = MilvusClient()
res = client.search(
    collection_name="quick_setup",
    anns_field="vector",
    ids=[1, 2, 4], # a list of primary keys
    filter='color like "red%" and likes > 50',
    output_fields=["color", "likes"],
    limit=3,
    search_params={"metric_type": "COSINE","params": {
            "radius": 0.4,
            "range_filter": 1.0
        }},
)
多向量混合检索
同一个实体,存储多个不同向量字段(多 Embedding),每一路向量单独 ANN 检索,服务端多路结果合并 + 重排,支持搭配 group_by_field
典型业务场景
- RAG:通用稠密向量 + 领域微调稠密向量 + BM25 稀疏向量,三路混合检索(最常用)
- 多模态:同一条数据,文本向量 + 图片向量,文搜图、图搜文
- 多模型融合:BGE、Text-Embedding、E5 多个 Embedding 模型分别编码,多路召回融合,提升召回鲁棒性
区分概念:
- 普通 hybrid:dense + sparse
- 多向量混合检索:集合内多个 FLOAR_VECTOR 稠密向量字段,再加可选 sparse 向量字段一起多路检索
执行流程
- 为每一个向量字段,单独创建
AnnSearchRequest,各自执行 ANN 检索,每一路召回 topK 候选 - 多路召回结果合并,去重(同一个实体多条命中合并)
- Ranker(RRF / Weighted)全局重排打分
- (可选)
group_by_field分组,例如按 doc_id,每个文档只保留最高分 chunk - 返回最终 limit 结果
准备数据
pythonfrom pymilvus import (
    MilvusClient, DataType, Function, FunctionType
)

client = MilvusClient(
)


def generate_dense_vector(dim):
    return [random.random() for _ in range(dim)]
def init_schema():

    schema = client.create_schema(auto_id=False)

    schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, description="product id")
    schema.add_field(field_name="text", datatype=DataType.VARCHAR, max_length=1000, enable_analyzer=True, description="raw text of product description")
    # 相似度检索
    schema.add_field(field_name="text_dense", datatype=DataType.FLOAT_VECTOR, dim=768, description="text dense embedding")
    # 稀疏向量字段,全文检索
    schema.add_field(field_name="text_sparse", datatype=DataType.SPARSE_FLOAT_VECTOR, description="text sparse embedding auto-generated by the built-in BM25 function")
    schema.add_field(field_name="image_dense", datatype=DataType.FLOAT_VECTOR, dim=512, description="image dense embedding")

    bm25_function = Function(
        name="text_bm25_emb",
        input_field_names=["text"],
        output_field_names=["text_sparse"],
        function_type=FunctionType.BM25,
    )
    schema.add_function(bm25_function)

    index_params = client.prepare_index_params()

    index_params.add_index(
        field_name="text_dense",
        index_name="text_dense_index",
        index_type="AUTOINDEX",
        metric_type="IP"
    )

    index_params.add_index(
        field_name="text_sparse",
        index_name="text_sparse_index",
        index_type="SPARSE_INVERTED_INDEX",
        metric_type="BM25",
        params={"inverted_index_algo": "DAAT_MAXSCORE"}, # or "DAAT_WAND" or "TAAT_NAIVE"
    )

    index_params.add_index(
        field_name="image_dense",
        index_name="image_dense_index",
        index_type="AUTOINDEX",
        metric_type="IP"
    )

    client.create_collection(
        collection_name="demo",
        schema=schema,
        index_params=index_params
    )

    import random


    data=[
        {
            "id": 0,
            "text": "Red cotton t-shirt with round neck",
            "text_dense": generate_dense_vector(768),
            "image_dense": generate_dense_vector(512)
        },
        {
            "id": 1,
            "text": "Wireless noise-cancelling over-ear headphones",
            "text_dense": generate_dense_vector(768),
            "image_dense": generate_dense_vector(512)
        },
        {
            "id": 2,
            "text": "Stainless steel water bottle, 500ml",
            "text_dense": generate_dense_vector(768),
            "image_dense": generate_dense_vector(512)
        }
    ]

    res = client.insert(
        collection_name="demo",
        data=data
    )

    print(f"Insert {len(data)} records to collection demo.")


import random

from pymilvus import AnnSearchRequest


query_text = "white headphones, quiet and comfortable"
query_dense_vector = generate_dense_vector(768)
query_multimodal_vector = generate_dense_vector(512)

search_param_1 = {
    "data": [query_dense_vector],
    "anns_field": "text_dense",
    "param": {"nprobe": 10},
    "limit": 2
}
request_1 = AnnSearchRequest(**search_param_1)

search_param_2 = {
    "data": [query_text],
    "anns_field": "text_sparse",
    "limit": 2,
    "param": {"nprobe": 10},
}
request_2 = AnnSearchRequest(**search_param_2)

search_param_3 = {
    "data": [query_multimodal_vector],
    "anns_field": "image_dense",
    "param": {"nprobe": 10},
    "limit": 2
}
request_3 = AnnSearchRequest(**search_param_3)

reqs = [request_1, request_2, request_3]

from pymilvus import  Function, FunctionType


# 混合搜索必须有排序器,对结果进行排序,默认使用RRF排序器
ranker = Function(
    name="rrf",
    input_field_names=[], # Must be an empty list
    function_type=FunctionType.RERANK,
    params={
        "reranker": "rrf",
        "k": 100  # Optional
    }
)

res = client.hybrid_search(
    collection_name="demo",
    reqs=reqs,
    ranker=ranker,
    limit=2
)
for hits in res:
    print("TopK results:")
    for hit in hits:
        print(hit)

本文作者:繁星
本文链接:
版权声明:本博客所有文章除特别声明外,均采用 BY-NC-SA 许可协议。转载请注明出处!