目录
Pandas 是一个开源的数据分析和数据处理库,它是基于 Python 编程语言的。
Pandas 提供了易于使用的数据结构和数据分析工具,特别适用于处理结构化数据,如表格型数据(类似于Excel表格)。
Pandas 是数据科学和分析领域中常用的工具之一,它使得用户能够轻松地从各种数据源中导入数据,并对数据进行高效的操作和分析。
1. Pandas数据结构-Series
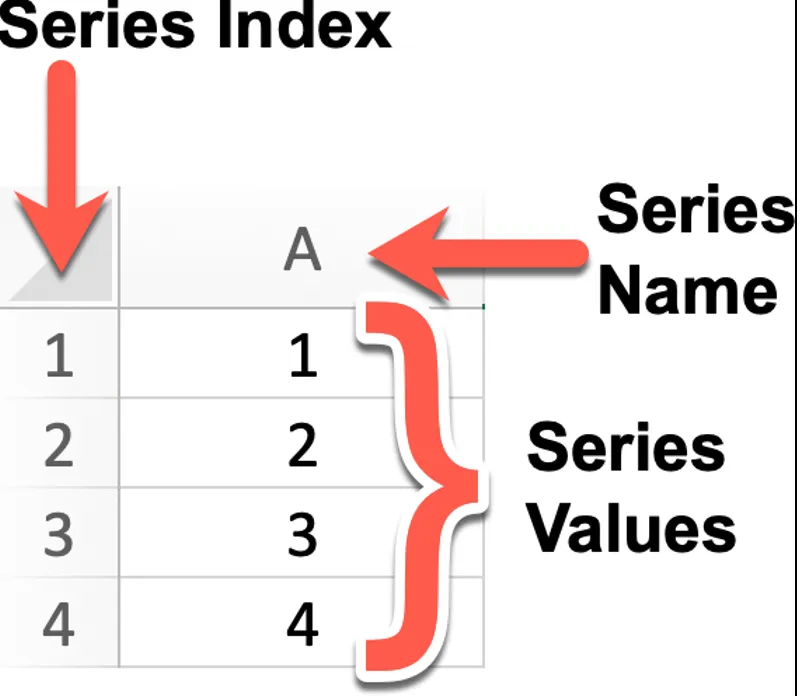
Series 是 Pandas 中的一个核心数据结构,类似于一个一维的数组,具有数据和索引。 Series 可以存储任何数据类型(整数、浮点数、字符串等),并通过标签(索引)来访问元素。Series 的数据结构是非常有用的,因为它可以处理各种数据类型,同时保持了高效的数据操作能力,比如可以通过标签来快速访问和操作数据。
Series 特点
- 一维数组:Series 中的每个元素都有一个对应的索引值。
- 索引: 每个数据元素都可以通过标签(索引)来访问,默认情况下索引是从 0 开始的整数,但你也可以自定义索引。
- 数据类型: Series 可以容纳不同数据类型的元素,包括整数、浮点数、字符串、Python 对象等。
- 大小不变性:Series 的大小在创建后是不变的,但可以通过某些操作(如 append 或 delete)来改变。
- 操作:Series 支持各种操作,如数学运算、统计分析、字符串处理等。
- 缺失数据:Series 可以包含缺失数据,Pandas 使用NaN(Not a Number)来表示缺失或无值。
- 自动对齐:当对多个 Series 进行运算时,Pandas 会自动根据索引对齐数据,这使得数据处理更加高效。
我们可以使用 Pandas 库来创建一个 Series 对象,并且可以为其指定索引(Index)、名称(Name)以及值(Values):
1.1 创建Series
pythonimport pandas as pd

s = pd.Series([4, 7, -5, 3])
print(s)
# 0    4
# 1    7
# 2   -5
# 3    3
# dtype: int64
Series的字符串表现形式为:索引在左边,值在右边。由于我们没有为数据指定索引,于是会自动创建一个0到N-1(N为数据的长度)的整数型索引。
1. 通过列表创建Series时指定索引
pythons = pd.Series([4, 7, -5, 3], index=["a", "b", "c", "d"])
print(s)
# a    4
# b    7
# c   -5
# d    3
# dtype: int64
2. 通过列表创建Series时指定索引和名称
pythons = pd.Series([4, 7, -5, 3], index=["a", "b", "c", "d"],name="hello_python")
print(s)
# a    4
# b    7
# c   -5
# d    3
# Name: hello_python, dtype: int6
3. 直接通过字典创建Series
pythondic = {"a": 4, "b": 7, "c": -5, "d": 3}
s = pd.Series(dic)
print(s)
# a    4
# b    7
# c   -5
# d    3
# dtype: int64
s1 = pd.Series(dic,index=["a","c"],name="aacc")
print(s1)
# a    4
# c   -5
# Name: aacc, dtype: int64
1.2 常用属性
| 属性 | 说明 |
|---|---|
index | Series 的索引对象(标签) |
values | Series 的值,返回 numpy array |
ndim | Series 的维度,永远 = 1(一维) |
shape | 形状,返回元组,如 (5,) 代表 5 个元素 |
size | 元素总个数,整数 |
dtype | 元素数据类型(Series 只有一种类型,用dtype;dtypes 多用于 DataFrame) |
name | Series 的名称,可用于后续合并、构建 DataFrame |
pythonimport pandas as pd
s = pd.Series([10,20,30], index=["a","b","c"], name="demo")

print(s.index)      # Index(['a', 'b', 'c'], dtype='object')
print(s.values)     # [10 20 30]
print(s.ndim)       # 1
print(s.shape)      # (3,)
print(s.size)       # 3
print(s.dtype)      # int64
print(s.name)       # demo
索引访问器
| 访问器 | 说明 |
|---|---|
loc[] | 显式索引(按标签),支持单个标签、标签列表、标签切片⚠️标签切片左右都包含 |
iloc[] | 隐式索引(按位置,从 0 开始),支持位置数字、列表、位置切片⚠️位置切片左闭右开 |
at[] | 标签取单个元素,速度比 loc 更快,只能单个值 |
iat[] | 位置取单个元素,速度比 iloc 更快,只能单个值 |
pythons = pd.Series([10,20,30], index=["a","b","c"])

print(s.loc["b"])        # 按标签b取值 →20
print(s.iloc[1])         # 按第1号位置取值 →20

print(s.at["b"])         # 标签取单个元素 →20
print(s.iat[1])          # 位置取单个元素 →20

# loc切片:包含首尾标签
print(s.loc["a":"b"])
# iloc切片:左闭右开
print(s.iloc[0:2])
1.3 常用方法
表格
| 方法 | 说明 | 关键要点 & 示例 |
|---|---|---|
head(n=5) | 查看前 n 行数据,默认 5 行 | s.head(3) 取前 3 条 |
tail(n=5) | 查看后 n 行数据,默认 5 行 | s.tail(2) 取最后 2 条 |
isin(集合) | 判断每个元素是否在传入集合中,返回布尔 Series | s.isin([2,4]),常用于筛选 |
isna() | 判断元素是否是缺失值 NaN/None,返回布尔 Series | 配套 s[s.isna()] 筛选缺失 |
sum() | 求和,自动忽略 NaN | s.sum() |
mean() | 平均值,忽略 NaN | s.mean() |
min() | 最小值,忽略 NaN | s.min() |
max() | 最大值,忽略 NaN | s.max() |
var() | 方差(样本方差,除以 n-1) | s.var() |
std() | 标准差(样本标准差) | s.std() |
median() | 中位数,忽略 NaN | s.median() 等价 s.quantile(0.5) |
mode() | 众数,返回 Series,支持多个众数 | 多个最高频值会全部返回 |
quantile(q, interpolation='linear') | 分位数q:0~1,可以是列表interpolation:插值方式linear/lower/higher/midpoint/nearest | s.quantile([0.25,0.5,0.75]) 四分位数 |
describe() | 一次性输出统计摘要:计数、均值、标准差、最值、四分位数 | 数值型 Series 最常用 |
value_counts() | 统计每个元素出现频次,返回按频次降序的 Series | ⚠️容易写错:不是 value_count |
count() | 非缺失值数量(不计 NaN) | 全部元素总数用 len(s) |
drop_duplicates() | 删除重复值,保留第一次出现的记录 | s.drop_duplicates() |
unique() | 返回去重后的 numpy 数组 | s.unique() |
nunique() | 去重后元素个数,默认排除 NaN | s.nunique() |
sample(n, frac) | 随机采样n:采样个数;frac:采样比例 | s.sample(3);s.sample(frac=0.3) |
sort_index() | 按索引排序 | s.sort_index(ascending=False) 降序 |
sort_values() | 按值排序 | s.sort_values(ascending=False) |
replace(old, new) | 替换值 | s.replace(99, np.nan) 把 99 替换成缺失值 |
to_frame() | Series → DataFrame | s.to_frame("col_name") |
equals(other) | 判断两个 Series 是否完全相同(索引、值、dtype 都一致) | s1.equals(s2) |
keys() | 返回 Series 索引对象,等价 .index | s.keys() |
corr(other) | 和另一个 Series 计算皮尔逊相关系数1 = 完全正相关;-1 = 完全负相关;0 无线性相关 | s1.corr(s2),只支持数值 |
cov(other) | 和另一个 Series 计算协方差 | 协方差正负代表变化同向 / 反向,大小受量纲影响 |
hist() | 绘制直方图,查看分布,依赖 matplotlib | s.hist(bins=10) |
items() | 遍历,返回(索引,值)迭代器 | for idx,val in s.items(): |
count():只统计非缺失值;len(s)包含 NaN,是总长度value_counts()末尾带 s,笔误value_count()直接报错mode()返回 Series,可能多条(多众数),不是单个标量quantile(0.5)= 中位数,但median()更直观corr只能衡量线性相关,相关系数 = 0 不代表没有任何关系sort_index按索引标签排序;sort_values按元素值排序,不要搞混
pythonimport pandas as pd
import numpy as np

s = pd.Series([1,2,2,3,3,3,np.nan], index=list("abcdefg"), name="data")

print("head:\n", s.head(3))
# head:
# a    1.0
# b    2.0
# c    2.0
# Name: data, dtype: float64


print("isin:\n", s.isin([2,3]))
# isin:
# a    False
# b     True
# c     True
# d     True
# e     True
# f     True
# g    False
# Name: data, dtype: bool


print("isna:\n", s.isna())
# isna:
# a    False
# b    False
# c    False
# d    False
# e    False
# f    False
# g     True
# Name: data, dtype: bool


print("sum:", s.sum())
# sum: 14.0


print("mean:", s.mean())
# mean: 2.3333333333333335


print("median:", s.median())
# median: 2.5

print("mode:\n", s.mode())
# mode:
# 0    3.0
# Name: data, dtype: float64


print("quantile 0.5:", s.quantile(0.5))
# quantile 0.5: 2.5


print("describe:\n", s.describe())
# describe:
# count    6.000000
# mean     2.333333
# std      0.816497
# min      1.000000
# 25%      2.000000
# 50%      2.500000
# 75%      3.000000
# max      3.000000
# Name: data, dtype: float64

print("value_counts:\n", s.value_counts())
# value_counts:
# data
# 3.0    3
# 2.0    2
# 1.0    1
# Name: data, dtype: int64


print("count(非空):", s.count(), "len(全部):", len(s))
# count(非空): 6 len(全部): 7


print("unique:", s.unique())
# unique: [ 1.  2.  3. nan]


print("nunique:", s.nunique())
# nunique: 3


print("drop_duplicates:\n", s.drop_duplicates())
# drop_duplicates:
# a    1.0
# b    2.0
# d    3.0
# g    NaN
# Name: data, dtype: float64


print("sort_values:\n", s.sort_values())
# sort_values:
# a    1.0
# b    2.0
# c    2.0
# d    3.0
# e    3.0
# f    3.0
# g    NaN
# Name: data, dtype: float64

print("to_frame:\n", s.to_frame())
# to_frame:
#    data
# a   1.0
# b   2.0
# c   2.0
# d   3.0
# e   3.0
# f   3.0
# g   NaN

# 相关系数&协方差
s2 = pd.Series([2,4,4,6,6,6,8])
print("corr:", s.corr(s2))
# corr: nan

print("cov:", s.cov(s2))
# cov: nan

# 遍历items
for k, v in s.items():
    print(k, v)
    # a 1.0
    # b 2.0
    # c 2.0
    # d 3.0
    # e 3.0
    # f 3.0
    # g nan
1.4 Series的布尔索引
可以使用布尔索引从Series中筛选满足某些条件的值。
pythons = pd.Series({"a": -1.2, "b": 3.5, "c": 6.8, "d": 2.9})
bools = s > s.mean()  # 将大于平均值的元素标记为 True
print(bools)
# a    False
# b     True
# c     True
# d    False
# dtype: bool
print(s[bools])
# b    3.5
# c    6.8
# dtype: float64
1.5 Series的运算
1)Series与标量运算 标量会与每个元素进行计算。
pythons = pd.Series({"a": -1.2, "b": 3.5, "c": 6.8, "d": 2.9})
print(s * 10)
# a   -12.0
# b    35.0
# c    68.0
# d    29.0
# dtype: float64
2)Series与Series运算 会根据标签索引进行对位计算,索引没有匹配上的会用NaN填充。
pythons1 = pd.Series([1, 1, 1, 1])
s2 = pd.Series([2, 2, 2, 2], index=[1, 2, 3, 4])
print(s1 + s2)
# 0    NaN
# 1    3.0
# 2    3.0
# 3    3.0
# 4    NaN
# dtype: float64
2. Pandas数据结构DataFrame
DataFrame是Pandas 中的另一个核心数据结构,类似于一个二维的表格或数据库中的数据表。它是一个表格型的数据结构,它含有一组有序的列,每列可以是不同的值类型(数值、字符串、布尔型值),既有行索引也有列索引。
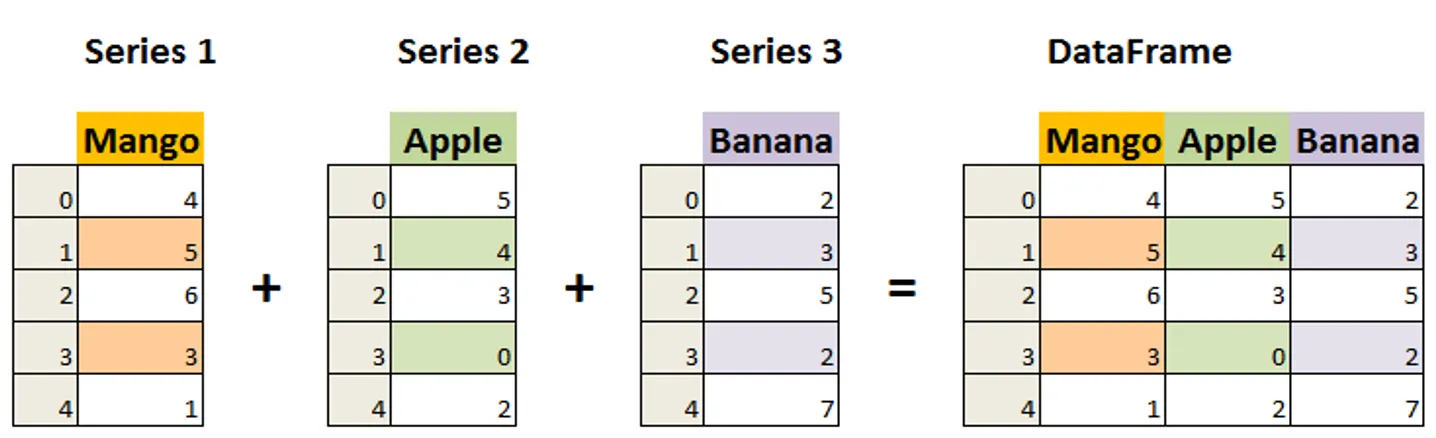
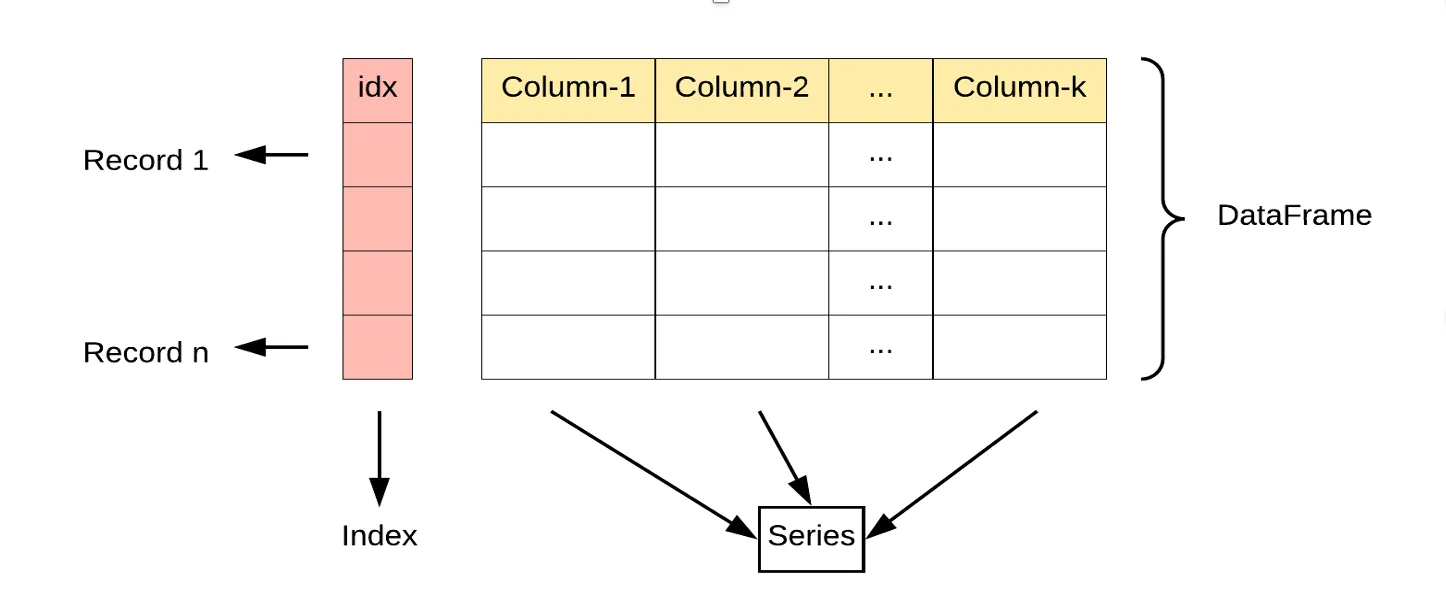 DataFrame中的数据是以一个或多个二维块存放的(而不是列表、字典或别的一维数据结构)。它可以被看做由Series组成的字典(共同用一个索引)。提供了各种功能来进行数据访问、筛选、分割、合并、重塑、聚合以及转换等操作,广泛用于数据分析、清洗、转换、可视化等任务。
2.1 DataFrame的创建
1)直接通过字典创建DataFrame
pythondf = pd.DataFrame({"id": [101, 102, 103], "name": ["张三", "李四", "王五"], "age": [20, 30, 40]})
print(df)
#     id name  age
# 0  101   张三   20
# 1  102   李四   30
# 2  103   王五   40
2)通过字典创建时指定列的顺序和行索引
python# 需要安装hypothesis 、pytest
df = pd.DataFrame(
    data={"age": [20, 30, 40], "name": ["张三", "李四", "王五"]}, columns=["name", "age"], index=[101, 102, 103]
)
print(df)
#     name  age
# 101   张三   20
# 102   李四   30
# 103   王五   40
2.2 Pandas DataFrame 属性 & 索引访问器
| 属性 / 访问器 | 说明 | 要点 |
|---|---|---|
index | DataFrame 的行索引 | 返回行标签对象,df.index |
columns | DataFrame 的列标签 | 返回列名对象,df.columns |
values | DataFrame 的值 | 返回二维 numpy 数组 |
ndim | DataFrame 的维度 | DataFrame 永远是2 维,ndim=2 |
shape | DataFrame 的形状 | 返回元组 (行数, 列数) |
size | DataFrame 元素总个数 | 行数 × 列数,包含 NaN |
dtypes | DataFrame 每一列的数据类型 | 返回 Series,索引是列名 |
T | 行列转置 | df.T,行变列、列变行 |
loc[] | 显式索引,按标签索引 / 切片 | loc[行标签, 列标签];标签切片首尾都包含 |
iloc[] | 隐式索引,按数字位置索引 / 切片 | iloc[行位置, 列位置];位置切片左闭右开 |
at[] | 标签访问单个元素 | 只能取一个值,速度优于 loc,格式at[行标签,列标签] |
iat[] | 位置访问单个元素 | 只能取一个值,速度优于 iloc,格式iat[行号,列号] |
pythonimport pandas as pd

df = pd.DataFrame(
    data=[[1,2],[3,4],[5,6]],
    index=["r1","r2","r3"],
    columns=["c1","c2"]
)

print("index:", df.index)
# index: Index(['r1', 'r2', 'r3'], dtype='object')

print("columns:", df.columns)
# columns: Index(['c1', 'c2'], dtype='object')

print("values:\n", df.values)
# values:
# [[1 2]
# [3 4]
# [5 6]]


print("ndim:", df.ndim)
# ndim: 2

print("shape:", df.shape)   # (3,2) 3行2列
# shape: (3, 2)

print("size:", df.size)     # 3*2=6
# size: 6

print("dtypes:\n", df.dtypes)
# dtypes:
# c1    int64
# c2    int64
# dtype: object

print("转置 df.T:\n", df.T)
#转置 df.T:
#     r1  r2  r3
# c1   1   3   5
# c2   2   4   6


# loc 按标签
print(df.loc["r2", "c2"]) # 4
# iloc 按位置
print(df.iloc[1,1]) # 4

# at / iat 取单个元素
print(df.at["r2", "c2"]) # 4
print(df.iat[1, 1]) # 4
2.3 Pandas DataFrame 常用方法
表格
| 方法 | 说明 | 关键要点 |
|---|---|---|
head(n=5) | 查看前 n 行,默认 5 行 | df.head(3) 看前 3 条 |
tail(n=5) | 查看后 n 行,默认 5 行 | df.tail(2) 看最后 2 条 |
isin(集合) | 判断每个元素是否在集合内,返回布尔 DataFrame | 常用于筛选:df[df["列名"].isin([1,2])] |
isna() | 判断元素是否为缺失值(NaN/None),返回布尔 DF | 搭配 df.isna().sum() 统计每列缺失数量 |
sum() | 求和,默认按列求和,自动忽略 NaN | df.sum(axis=1) 按行求和 |
mean() | 平均值,忽略 NaN | df["A"].mean() 单列均值 |
min() | 最小值,忽略 NaN | |
max() | 最大值,忽略 NaN | |
var() | 方差(样本方差) | |
std() | 标准差 | |
median() | 中位数 | |
mode() | 众数,返回 DF,支持多众数 | |
quantile(q) | 分位数;quantile(0.5) 中位数 | 可以传列表 quantile([0.25,0.5,0.75]) |
describe() | 统计摘要:count,mean,std,min, 四分位数,max | 默认只对数值列计算 |
info() | 数据集基本信息:行数、列名、类型、非空数量、内存占用 | 查看缺失和数据类型首选,不输出统计值 |
value_counts() | 统计一列中每个元素出现次数,返回 Series | 单列使用:df["col"].value_counts() |
count() | 统计非空元素个数,默认按列 | df.count() 每列非空数量 |
drop_duplicates() | 去重,默认整行完全相同才删除,保留第一次出现 | df.drop_duplicates(subset=["A","B"]) 指定按多列去重 |
sample() | 随机采样 | df.sample(n=3) 取 3 行;df.sample(frac=0.2) 取 20% 数据 |
replace(old, new) | 替换值 | df.replace(99, np.nan) |
equals(other) | 判断两个 DataFrame 是否完全相同 | 索引、行列顺序、值、dtype 全部一致才返回 True |
cummax() | 累计最大值 | 逐行累积,到当前位置为止最大的值 |
cummin() | 累计最小值 | |
cumsum() | 累计和 | |
cumprod() | 累计积 | |
diff(periods=1, axis=0) | 一阶差分:当前元素 - 前 periods 个元素periods>0 向前减;axis=0 按列差分(默认),axis=1 按行差分 | df["A"].diff() 最常用,求相邻差值 |
sort_index() | 按行索引排序 | df.sort_index(ascending=False) 索引降序 |
sort_values() | 按列的值排序,支持多列排序,ascending控制升降序 | df.sort_values(by=["col1","col2"], ascending=[True,False]) |
nlargest(n, columns) | 返回某列数值最大的 n 行数据 | df.nlargest(5, "score") 分数最高 5 条 |
nsmallest(n, columns) | 返回某列数值最小的 n 行数据 | df.nsmallest(3, "price") 价格最低 3 条 |
info()是打印信息,没有返回统计数字;describe()输出统计指标diff()默认periods=1,本行减去上一行;periods=2本行减去上上行sort_values的by参数可以传列表实现多列排序,ascending也要对应列表nlargest/nsmallest是DataFrame 方法,指定列名取行,很适合 TopN 场景drop_duplicates默认整行匹配;subset可以指定只看部分列判断重复
pythonimport pandas as pd
import numpy as np

df = pd.DataFrame({
    "A":[2,4,6,8,np.nan,10],
    "B":[1,3,3,5,5,5]
})

print("head:\n", df.head(3))
#head:
#      A  B
# 0  2.0  1
# 1  4.0  3
# 2  6.0  3

print("isin:\n", df["B"].isin([3,5]))
# isin:
# 0    False
# 1     True
# 2     True
# 3     True
# 4     True
# 5     True
# Name: B, dtype: bool


print("isna:\n", df.isna())
# isna:
#        A      B
# 0  False  False
# 1  False  False
# 2  False  False
# 3  False  False
# 4   True  False
# 5  False  False


print("sum:\n", df.sum())
# sum:
# A    30.0
# B    22.0
# dtype: float64

print("mean:\n", df["A"].mean())
# mean:
#  6.0


print("quantile 0.5:\n", df["A"].quantile(0.5))
# quantile 0.5:
#  6.0


print("describe:\n", df.describe())
#describe:
#                A         B
# count   5.000000  6.000000
# mean    6.000000  3.666667
# std     3.162278  1.632993
# min     2.000000  1.000000
# 25%     4.000000  3.000000
# 50%     6.000000  4.000000
# 75%     8.000000  5.000000
# max    10.000000  5.000000


print("info:")
# info:
# <class 'pandas.core.frame.DataFrame'>
# RangeIndex: 6 entries, 0 to 5
# Data columns (total 2 columns):
# #   Column  Non-Null Count  Dtype
# ---  ------  --------------  -----
# 0   A       5 non-null      float64
# 1   B       6 non-null      int64
# dtypes: float64(1), int64(1)
# memory usage: 224.0 bytes


df.info()
print("value_counts:\n", df["B"].value_counts())
# value_counts:
#  B
# 5    3
# 3    2
# 1    1
# Name: B, dtype: int64


print("count:\n", df.count())
# count:
# A    5
# B    6
# dtype: int64

print("cumsum:\n", df["A"].cumsum())
# cumsum:
# 0     2.0
# 1     6.0
# 2    12.0
# 3    20.0
# 4     NaN
# 5    30.0
# Name: A, dtype: float64


print("diff:\n", df["A"].diff())
# diff:
# 0    NaN
# 1    2.0
# 2    2.0
# 3    2.0
# 4    NaN
# 5    NaN
# Name: A, dtype: float64


print("sort_values:\n", df.sort_values(by="B", ascending=False))
# sort_values:
#       A  B
# 3   8.0  5
# 4   NaN  5
# 5  10.0  5
# 1   4.0  3
# 2   6.0  3
# 0   2.0  1


print("nlargest:\n", df.nlargest(2, "A"))
# nlargest:
#       A  B
# 5  10.0  5
# 3   8.0  5
2.4 DataFrame的布尔索引
可以使用布尔索引从DataFrame中筛选满足某些条件的行。
pythondf = pd.DataFrame(
    data={"age": [20, 30, 40, 10], "name": ["张三", "李四", "王五", "赵六"]},
    columns=["name", "age"],
    index=[101, 104, 103, 102],
)
print(df["age"] > 25)
print(df[df["age"] > 25])
#101    False
#104     True
#103     True
#102    False
Name: age, dtype: bool
#     name  age
# 104   李四   30
# 103   王五   40
2.5 DataFrame的运算
1)DataFrame与标量运算 标量与每个元素进行计算。
pythondf = pd.DataFrame(
    data={"age": [20, 30, 40, 10], "name": ["张三", "李四", "王五", "赵六"]},
    columns=["name", "age"],
    index=[101, 104, 103, 102],
)
print(df * 2)
#      name  age
# 101  张三张三   40
# 104  李四李四   60
# 103  王五王五   80
# 102  赵六赵六   20
2)DataFrame与DataFrame运算 根据标签索引进行对位计算,索引没有匹配上的用NaN填充。
pythondf1 = pd.DataFrame(
    data={"age": [10, 20, 30, 40], "name": ["张三", "李四", "王五", "赵六"]},
    columns=["name", "age"],
    index=[101, 102, 103, 104],
)
df2 = pd.DataFrame(
    data={"age": [10, 20, 30, 40], "name": ["张三", "李四", "王五", "田七"]},
    columns=["name", "age"],
    index=[102, 103, 104, 105],
)
print(df1 + df2)
#      name   age
# 101   NaN   NaN
# 102  李四张三  30.0
# 103  王五李四  50.0
# 104  赵六王五  70.0
# 105   NaN   NaN
2.6 DataFrame的更改操作
1)设置行索引 创建DataFrame时如果不指定行索引,pandas会自动添加从0开始的索引。
pythondf = pd.DataFrame({"age": [20, 30, 40, 10], "name": ["张三", "李四", "王五", "赵六"], "id": [101, 102, 103, 104]})
print(df)
#    age name   id
# 0   20   张三  101
# 1   30   李四  102
# 2   40   王五  103
# 3   10   赵六  104
(1)通过set_index()设置行索引
python# inplace=True:这是一个布尔类型的参数。当设为 True 时,会直接在原
# DataFrame上进行修改;若设为 False(默认值),则会返回一个新的
# DataFrame,原DataFrame 保持不变
df.set_index("id", inplace=True)  # 设置行索引
print(df)
#      age name
# id
# 101   20   张三
# 102   30   李四
# 103   40   王五
# 104   10   赵六
(2)通过reset_index()重置行索引
pythondf.reset_index(inplace=True)  # 重置索引
print(df)
#     id  age name
# 0  101   20   张三
# 1  102   30   李四
# 2  103   40   王五
# 3  104   10   赵六
2)修改行索引名和列名 (1)通过rename()修改行索引名和列名
pythondf = pd.DataFrame({"age": [20, 30, 40, 10], "name": ["张三", "李四", "王五", "赵六"], "id": [101, 102, 103, 104]})
df.set_index("id", inplace=True)
print(df)
#      age name
# id
# 101   20   张三
# 102   30   李四
# 103   40   王五
# 104   10   赵六

df.rename(index={101: "一", 102: "二", 103: "三", 104: "四"}, columns={"age": "年龄", "name": "姓名"}, inplace=True)
print(df)
#     年龄  姓名
# id
# 一   20  张三
# 二   30  李四
# 三   40  王五
# 四   10  赵六
(2)将index和columns重新赋值
pythondf.index = ["Ⅰ", "Ⅱ", "Ⅲ", "Ⅳ"]
df.columns = ["年齡", "名稱"]
print(df)
#    年齡  名稱
# Ⅰ  20  张三
# Ⅱ  30  李四
# Ⅲ  40  王五
# Ⅳ  10  赵六
3)添加列 通过 df[“列名”] 添加列。
pythondf["phone"] = ["13333333333", "14444444444", "15555555555", "16666666666"]
print(df)
#      age name          phone
# id
# 101   20   张三   13333333333
# 102   30   李四   14444444444
# 103   40   王五   15555555555
# 104   10   赵六   16666666666
4)删除列 (1)通过 df.drop(“列名”, axis=1) 删除,也可是删除行 axis=0
pythondf.drop("phone", axis=1, inplace=True)  # 删除phone,按列删除,inplace=True表示直接在原对象上修改
print(df)
#      age name
# id
# 101   20   张三
# 102   30   李四
# 103   40   王五
# 104   10   赵六
(2)通过 del df[“列名”] 删除
pythondel df["phone"]
print(df)
#      age name
# id
# 101   20   张三
# 102   30   李四
# 103   40   王五
# 104   10   赵六
5)插入列 通过 insert(loc, column, value) 插入。该方法没有inplace参数,直接在原数据上修改。
pythondf.insert(loc=0, column="phone", value=df["age"] * df.index)
print(df)
#      phone  age name
# id
# 101   2020   20   张三
# 102   3060   30   李四
# 103   4120   40   王五
# 104   1040   10   赵六
2.7 DataFrame数据的导入与导出
导出数据
| 方法 | 说明 | 关键参数 & 要点 |
|---|---|---|
to_csv() | 保存为 csv 文本文件,默认逗号分隔 | sep 指定分隔符;index=True/False 是否导出行索引;header=True/False 是否导出列名例:df.to_csv("data.csv", index=False, encoding="utf-8-sig") |
to_pickle() | 保存为 pickle 二进制文件,适合 Python 中间结果 | 后缀 .p/.pkl/.pickle;仅限 Python 读取,不能用其他软件打开,可完整保存数据类型、索引信息例:df.to_pickle("data.pkl") |
to_excel() | 保存 Excel(.xlsx) | 依赖openpyxl;index=False 不输出行索引例:df.to_excel("data.xlsx", index=False) |
to_clipboard() | 复制到系统剪贴板,直接粘贴到 Excel / 记事本 | df.to_clipboard(index=False) |
to_dict() | 转为 Python 字典,支持多种 orient 字典结构 | orient='records' 常用,输出[{列:值},...]列表字典 |
to_hdf() | HDF5 二进制存储,适合大数据 | 需要tables库;适合大量数值型数据,可分块读写 |
to_html() | 输出 html 表格代码 | 依赖lxml等,用于网页展示表格 |
to_json() | 保存 JSON 文件 | orient参数控制 json 结构,force_ascii=False保留中文 |
to_feather() | Feather 二进制格式,Python 与 R 语言互通 | 需要pyarrow;读写速度远快于 csv;多用于语言间传递中间数据,不适合长期归档保存 |
to_sql() | 将 DataFrame 写入数据库表 | 需要数据库驱动(pymysql/sqlalchemy);name表名,con数据库连接 |
pythonimport os
import pandas as pd

os.makedirs("data", exist_ok=True)
df = pd.DataFrame({"age": [20, 30, 40, 10], "name": ["张三", "李四", "王五", "赵六"], "id": [101, 102, 103, 104]})
df.set_index("id", inplace=True)

df.to_csv("data/df.csv")
df.to_csv("data/df.tsv", sep="\t")  # 设置分隔符为 \t
df.to_csv("data/df_noindex.csv", index=False)  # index=False 不保存行索引
df.to_pickle("data/df.pkl")
df.to_excel("data/df.xlsx")
df.to_clipboard()
df_dict = df.to_dict()
df.to_hdf("data/df.h5", key="df")
df.to_html("data/df.html")
df.to_json("data/df.json")
df.to_feather("data/df.feather")
导入数据
| 方法 | 说明 | 关键参数 & 要点 |
|---|---|---|
read_csv() | 加载 csv 文本文件 | sep 指定分隔符;index_col 指定某列作为行索引读取 tsv:sep="\t" |
read_pickle() | 加载 pickle 二进制文件 | 仅 Python 可用,完整还原索引、数据类型 |
read_excel() | 加载 Excel(xlsx/xls) | 需要openpyxl;index_col指定行索引,sheet_name指定工作表 |
read_clipboard() | 读取剪贴板里的表格数据 | 复制表格后直接读取,快速临时导入 |
read_hdf() | 加载 HDF 文件 | 需要tables;key参数指定读取内部的表 |
read_html() | 读取网页里的<table>表格 | 返回DataFrame 列表,需要lxml;一般取[0]拿第一个表格 |
read_json() | 加载 JSON 文件 | orient控制解析结构;force_ascii=False适配中文 |
read_feather() | 加载 feather 二进制文件 | 需要pyarrow;⚠️不会读取原索引,索引会变成普通列 |
read_sql() | 从数据库读取数据 | 需要数据库连接对象con,搭配 SQLAlchemy;写 SQL 查询语句 |
pythondf_csv = pd.read_csv("data/df.csv", index_col="id")  # 指定行索引
df_tsv = pd.read_csv("data/df.tsv", sep="\t")  # 指定分隔符
df_pkl = pd.read_pickle("data/df.pkl")
df_excel = pd.read_excel("data/df.xlsx", index_col="id")
df_clipboard = pd.read_clipboard(index_col="id")
df_from_dict = pd.DataFrame(df_dict)
df_hdf = pd.read_hdf("data/df.h5", key="df")
df_html = pd.read_html("data/df.html", index_col=0)[0]
df_json = pd.read_json("data/df.json")
df_feather = pd.read_feather("data/df.feather")

print(df_csv)
print(df_tsv)
print(df_pkl)
print(df_excel)
print(df_clipboard)
print(df_from_dict)
print(df_hdf)
print(df_html)
print(df_json)
print(df_feather)
4 Pandas日期数据处理初识
4.1 to_datetime()进行日期格式转换
参数说明
| 参数名 | 说明 |
|---|---|
arg | 要转换为日期时间的对象,可以是字符串、列表、Series、数组 |
errors | 可选值:ignore / raise / coerce⚠️你笔记这里纠正:默认是 raise,不是 ignoreraise:解析失败直接抛出异常;ignore:解析失败返回原值;coerce:解析失败转为 NaT(时间类型缺失值) |
dayfirst | True:日在前,"10/11/12" → 2012-11-10;默认 False(月在前) |
yearfirst | True:年在前,"10/11/12" → 2010-11-12如果dayfirst和yearfirst同时为 True,yearfirst 优先级更高。4 位年份的字符串如'2010/1/4',pandas 自动识别,不受该参数影响 |
utc | 布尔值。True 返回 UTC 协调世界时间,生成带时区的 datetime64 [ns, UTC] |
format | 时间格式化字符串,例如 "%Y-%m-%d %H:%M:%S"。None自动猜测格式;指定 format 解析速度更快 |
exact | 是否要求字符串完全匹配 format。默认 True;False 允许宽松匹配 |
unit | 时间单位,用于解析时间戳数字。s秒、ms毫秒、us微秒、ns纳秒 |
infer_datetime_format | True,不指定 format 时,根据第一个非空元素自动推断格式,解析提速 5~10 倍 |
origin | 基准起始日期,默认"unix",对应 1970-01-01;用于数字时间戳转换 |
cache | 开启缓存,重复日期字符串复用转换结果,大量重复日期时显著提速 |
NaT:datetime 类型的缺失值,和数值的NaN对应dayfirst/yearfirst只针对两位数字的年份才会产生歧义;4 位年份自动识别不受影响origin配合数字时间戳使用,unix 时间戳从 1970-01-01 开始cache适合大量重复日期字符串场景
2)将字符串字段转换为日期类型
pythonimport pandas as pd
df = pd.DataFrame({"gmv":[100,200,300,400],"trade_date":["2025-01-06","2023-10-31","2023-12-31","2023-01-05"]})
df["ymd"] = pd.to_datetime(df["trade_date"])
print(df)
import pandas as pd
df = pd.DataFrame({"gmv":[100,200,300,400],"trade_date":["2025-01-06","2023-10-31","2023-12-31","2023-01-05"]})
df["ymd"] = pd.to_datetime(df["trade_date"])
print(df)
#  gmv  trade_date        ymd
#  0  100  2025-01-06 2025-01-06
#  1  200  2023-10-31 2023-10-31
#  2  300  2023-12-31 2023-12-31
#  3  400  2023-01-05 2023-01-05
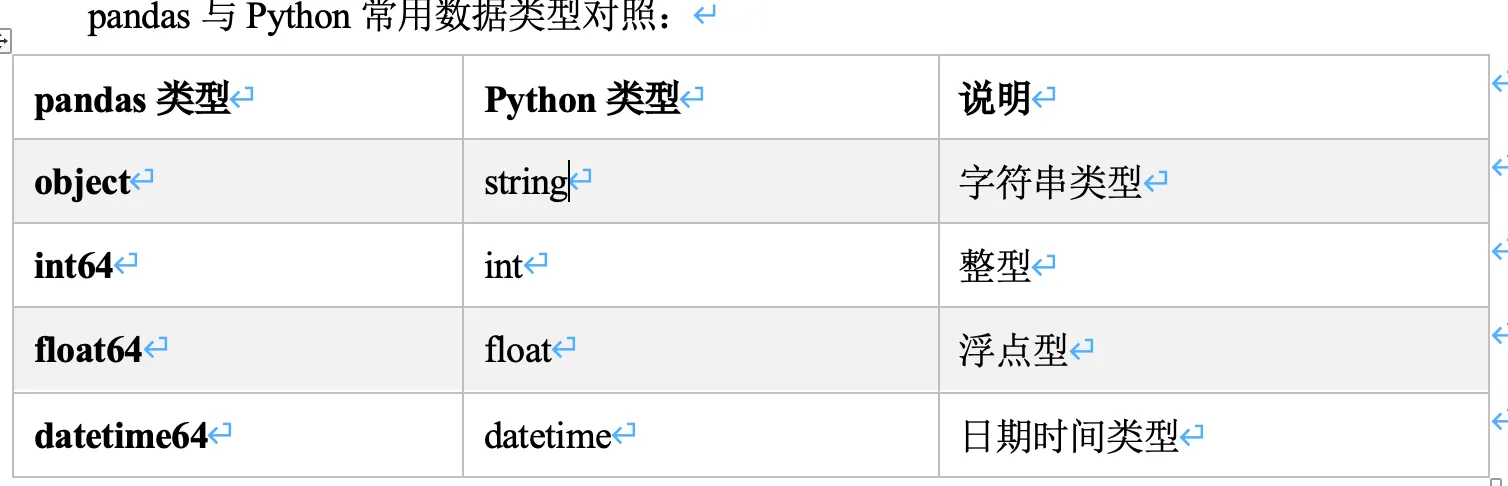
4.2 时间属性访问器对象Series.dt,获取日期数据的年月日星期
1)获取年月日
pythondf['yy'],df['mm'],df['dd']=df['ymd'].dt.year,df['ymd'].dt.month,df['ymd'].dt.day
print(df)
#    gmv  trade_date        ymd    yy  mm  dd
# 0  100  2025-01-06 2025-01-06  2025   1   6
# 1  200  2023-10-31 2023-10-31  2023  10  31
# 2  300  2023-12-31 2023-12-31  2023  12  31
# 3  400  2023-01-05 2023-01-05  2023   1   5
2)获取星期
pythondf['week']=df['ymd'].dt.day_name()
print(df)
3)获取日期所在季度
pythondf['quarter']=df['ymd'].dt.quarter
print(df)
4)判断日期是否月底年底
pythondf['mend']=df['ymd'].dt.is_month_end
df['yend']=df['ymd'].dt.is_year_end
print(df)
4.3 to_period()获取统计周期
freq:这是 to_period() 方法最重要的参数,用于指定要转换的时间周期频率 常见的取值如下:
- "D":按天周期,例如 2024-01-01 会转换为 2024-01-01 这个天的周期。
- "W":按周周期,通常以周日作为一周的结束,比如日期落在某一周内,就会转换为该周的周期表示。
- "M":按月周期,像 2024-05-15 会转换为 2024-05。
- "Q":按季度周期,一年分为四个季度,日期会转换到对应的季度周期,例如 2024Q2 。
- "A" 或 "Y":按年周期,如 2024-07-20 会转换为 2024 。
pythondf["ystat"] = df["ymd"].dt.to_period("Y")
df["mstat"] = df["ymd"].dt.to_period("M")
df["qstat"] = df["ymd"].dt.to_period("Q")
df["wstat"] = df["ymd"].dt.to_period("W")
print(df)
5. 数据分析
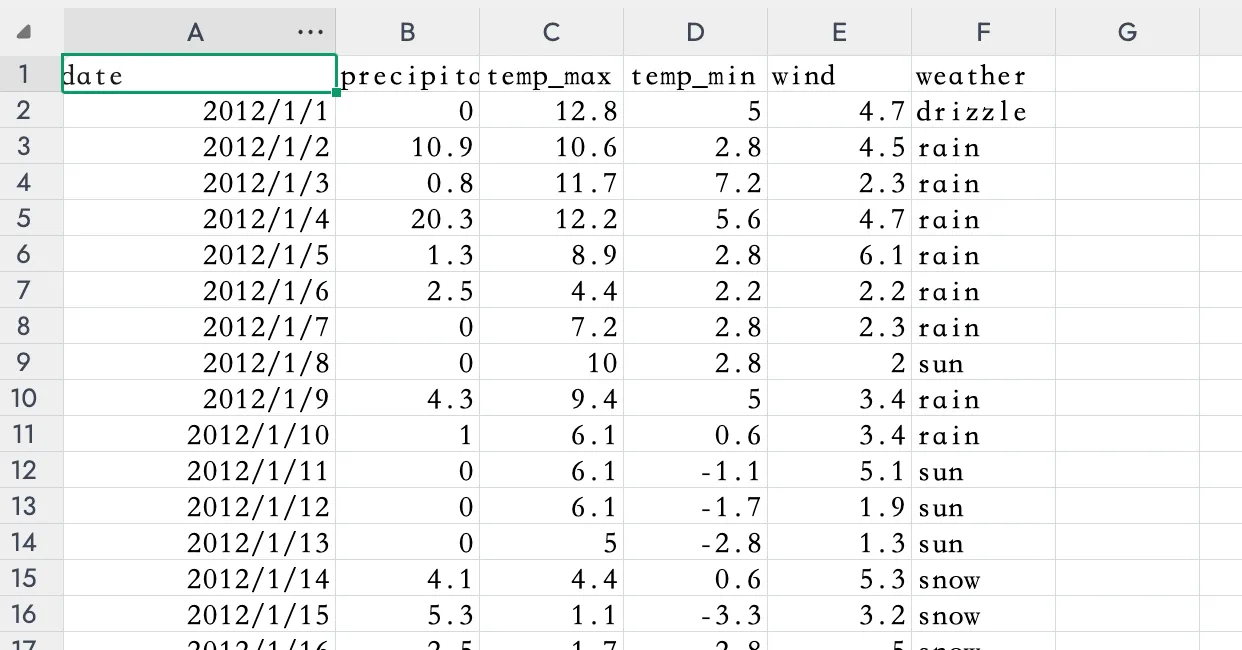
案例weather.csv
5.1 加载数据
使用weather(天气)数据集。其中包含6个字段:
- date:日期,年-月-日格式。
- precipitation:降水量。
- temp_max:最高温度。
- temp_min:最低温度。
- wind:风力。
- weather:天气状况。
pythonimport pandas as pd

df = pd.read_csv("data/weather.csv")
print(type(df))  # 查看df类型
print(df.shape)  # 查看df形状
print(df.columns)  # 查看df的列名
print(df.dtypes)  # 查看df各列数据类型
df.info()  # 查看df基本信息
5.2 查看部分数据
1)通过head()、tail()获取前n行或后n行
pythonprint(df.head())
print(df.tail(10))
2)获取一列或多列数据 (1)加载一列数据
pythondf_date_series = df["date"]  # 返回的是Series
df_date_dataframe = df[["date"]]  # 返回的是DataFrame
(2)加载多列数据
pythondf[["date", "temp_max", "temp_min"]] # 获取多列数据
3)按行获取数据 (1)loc:通过行标签获取数据
pythondf.loc[1]  # 获取行标签为1的数据
df.loc[[1, 10, 100]]  # 获取行标签分别为1、10、100的数据
(2)iloc:通过行位置获取数据
pythondf.iloc[0]  # 获取行位置为0的数据
df.iloc[-1]  # 获取行位置为最后一位的数据
4)获取指定行与列的数据
pythondf.loc[1, "precipitation"]  # 获取行标签为1,列标签为precipitation的数据
df.loc[:, "precipitation"]  # 获取所有行,列标签为precipitation的数据
df.iloc[:, [3, 5, -1]]  # 获取所有行,列位置为3,5,最后一位的数据
df.iloc[:10, 2:6]  # 获取前10行,列位置为2、3、4、5的数据
df.loc[:10, ["date", "precipitation", "temp_max", "temp_min"]]  # 通过行列标签获取数据
5.3 分组聚合计算
pythondf.groupby("分组字段")["要聚合的字段"].聚合函数()
df.groupby(["分组字段", "分组字段2", ...])[["要聚合的字段", "要聚合的字段2", ...]].聚合函数()
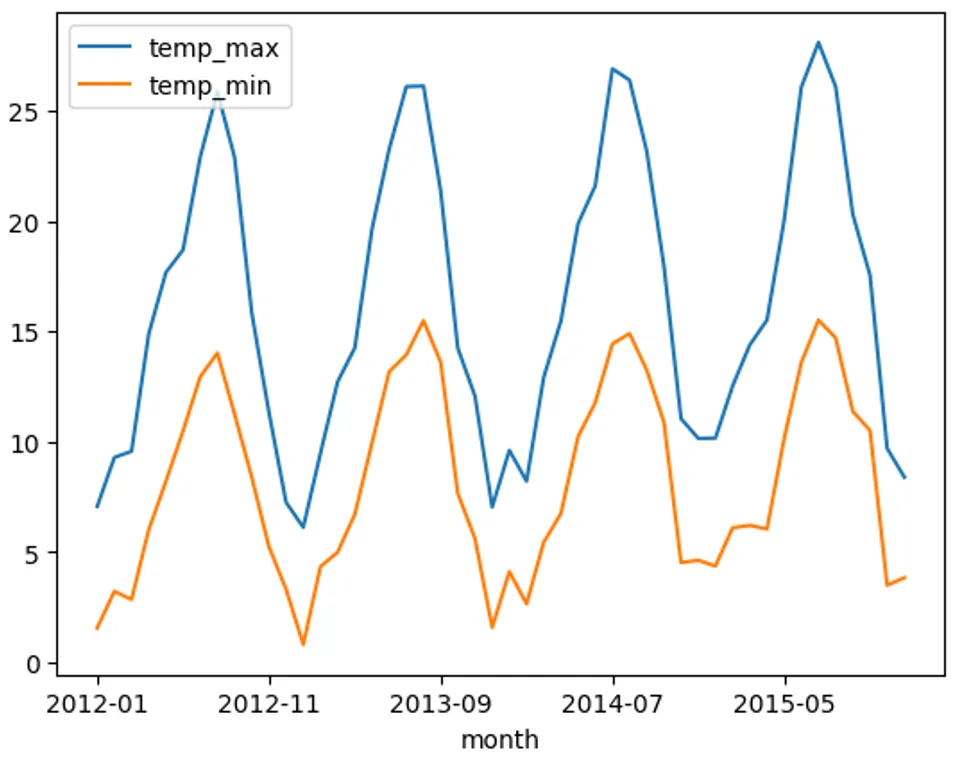
(1)将数据按月分组,并统计最大温度和最小温度的平均值
df["month"] = pd.to_datetime(df["date"]).dt.to_period("M").astype(str)  # 将date转换为 年-月 的格式

df_groupby_date = df.groupby("month")  # 按month分组,返回一个分组对象(DataFrameGroupBy)
month_temp = df_groupby_date[["temp_max", "temp_min"]]  # 从分组对象中选择特定的列
month_temp_mean = month_temp.mean()  # 对每个列求平均值

# 以上代码可以写在一起
month_temp_mean = df.groupby("month")[["temp_max", "temp_min"]].mean()
#           temp_max   temp_min
# month
# 2012-01   7.054839   1.541935
# 2012-02   9.275862   3.203448
# 2012-03   9.554839   2.838710
# 2012-04  14.873333   5.993333
# 2012-05  17.661290   8.190323
分组后默认会将分组字段作为行索引。如果分组字段有多个,得到的是复合索引。 (2)分组频数计算 统计每个月不同天气状况的数量。
df.groupby("month")["weather"].nunique()
# date
# 2012-01    4
# 2012-02    4
# 2012-03    4
# 2012-04    4
# 2012-05    3
5.4 基本绘图
plot():pandas 提供的绘图方法,它基于 matplotlib 库。将前面计算得到的均值结果绘制成图表,默认情况下会绘制折线图,其中 "month" 作为 x 轴,"temp_max" 和 "temp_min" 的均值作为 y 轴。
df.groupby("month")[["temp_max", "temp_min"]].mean().plot() # 使用plot绘制折线图
5.5 常用统计值
可通过describe()查看常用统计信息。
df.describe()  # 查看常用统计信息
df.describe().T  # 行列转置
可通过include参数指定要统计哪些数据类型的列。
df.describe(include="all")  # 统计所有列
df.describe(include=["float64"])  # 只统计数据类型为float64的列
5.6 常用排序方法
nlargest(n, [列名1, 列名2, …]):按列排序的最大n个 nsmallest(n, [列名1, 列名2, …]):按列排序的最小n个 sort_values([列名1, 列名2, …], asceding=[True, False, …]):按列升序或降序排序 drop_duplicates(subset=[列名1, 列名2]):按列去重 (1)找到最高温度最大的30天 通过nlargest()找出temp_max最大的30条数据。
df = pd.read_csv("data/weather.csv")
df.nlargest(30, "temp_max")
(2)从最高温度最大的30天中找出最低温度最小的5天 通过nlargest()找出temp_min最小的5条数据。
df.nlargest(30, "temp_max").nsmallest(5, "temp_min")
(3)找出每年的最高温度
df["year"] = pd.to_datetime(df["date"]).dt.to_period("Y").astype(str)  # 将date转换为 年 格式
df_sort = df.sort_values(["year", "temp_max"], ascending=[True, False])  # 按year升序,temp_max降序排序
df_sort.drop_duplicates(subset="year")  # 按year去重
#             date  precipitation  temp_max  temp_min  wind weather  year
# 228   2012-08-16            0.0      34.4      18.3   2.8     sun  2012
# 546   2013-06-30            0.0      33.9      17.2   2.5     sun  2013
# 953   2014-08-11            0.5      35.6      17.8   2.6    rain  2014
# 1295  2015-07-19            0.0      35.0      17.2   3.3     sun  2015
6 Padas的数据组合函数
6.1 concat连接
沿着一条轴将多个对象堆叠到一起,可通过axis参数设置沿哪一条轴连接。 1)Series与Series连接
pythons1 = pd.Series(["A", "B"], index=[1, 2])
s2 = pd.Series(["D", "E"], index=[4, 5])
s3 = pd.Series(["G", "H"], index=[7, 8])

pd.concat([s1, s2, s3])  # 按行连接
# 1    A
# 2    B
# 4    D
# 5    E
# 7    G
# 8    H
# dtype: object

pd.concat([s1, s2, s3], axis=1)  # 按列连接
#      0    1    2
# 1    A  NaN  NaN
# 2    B  NaN  NaN
# 4  NaN    D  NaN
# 5  NaN    E  NaN
# 7  NaN  NaN    G
# 8  NaN  NaN    H
缺失值会用NaN填充。
2)DataFrame与Series连接
pythondf1 = pd.DataFrame(data={"a": [1, 2], "b": [4, 5]}, index=[1, 2])
s1 = pd.Series(data=[7, 10], index=[1, 2], name="a")

pd.concat([df1, s1])  # 按行连接
#     a    b
# 1   1  4.0
# 2   2  5.0
# 1   7  NaN
# 2  10  NaN

pd.concat([df1, s1], axis=1)  # 按列连接
#    a  b   a
# 1  1  4   7
# 2  2  5  10
3)DataFrame与DataFrame连接
pythondf1 = pd.DataFrame(data={"a": [1, 2], "b": [4, 5]}, index=[1, 2])
df2 = pd.DataFrame(data={"a": [7, 8], "b": [10, 11]}, index=[1, 2])

pd.concat([df1, df2])  # 按行连接
#    a   b
# 1  1   4
# 2  2   5
# 1  7  10
# 2  8  11

pd.concat([df1, df2], axis=1)  # 按列连接
#    a  b  a   b
# 1  1  4  7  10
# 2  2  5  8  11
4)重置索引 可通过ignore_index=True来重置索引。
pythondf1 = pd.DataFrame(data={"a": [1, 2], "b": [4, 5]}, index=[1, 2])
df2 = pd.DataFrame(data={"a": [7, 8], "b": [10, 11]}, index=[1, 2])

pd.concat([df1, df2], ignore_index=True)  # 重置索引
#    a   b
# 0  1   4
# 1  2   5
# 2  7  10
# 3  8  11
5)类似join的连接 默认的合并方式是对其他轴进行并集合并(join=outer),可以用join=inner实现其他轴上的交集合并。
pythondf1 = pd.DataFrame(data={"a": [1, 2], "b": [4, 5]}, index=[1, 2])
df2 = pd.DataFrame(data={"b": [7, 8], "c": [10, 11]}, index=[2, 3])

pd.concat([df1, df2])
#      a  b     c
# 1  1.0  4   NaN
# 2  2.0  5   NaN
# 2  NaN  7  10.0
# 3  NaN  8  11.0

pd.concat([df1, df2], join="inner")
#    b
# 1  4
# 2  5
# 2  7
# 3  8
6.2 merge合并
通过一个或多个列将行连接。 1)数据连接的类型 merge()实现了三种数据连接的类型:一对一、多对一和多对多。 (1)一对一连接
pythondf1 = pd.DataFrame(
    {"employee": ["Bob", "Jake", "Lisa", "Sue"], "group": ["Accounting", "Engineering", "Engineering", "HR"]}
)
df2 = pd.DataFrame({"employee": ["Lisa", "Bob", "Jake", "Sue"], "hire_date": [2004, 2008, 2012, 2014]})
print(df1)
#   employee        group
# 0      Bob   Accounting
# 1     Jake  Engineering
# 2     Lisa  Engineering
# 3      Sue           HR
print(df2)
#   employee  hire_date
# 0     Lisa       2004
# 1      Bob       2008
# 2     Jake       2012
# 3      Sue       2014
# 通过相同的字段名employee进行关联的
df3 = pd.merge(df1, df2)
print(df3)
#   employee        group  hire_date
# 0      Bob   Accounting       2008
# 1     Jake  Engineering       2012
# 2     Lisa  Engineering       2004
# 3      Sue           HR       2014
(2)多对一连接 在需要连接的两个列中,有一列的值有重复。通过多对一连接获得的结果将会保留重复值。
pythondf1 = pd.DataFrame(
    {"employee": ["Bob", "Jake", "Lisa", "Sue"], "group": ["Accounting", "Engineering", "Engineering", "HR"]}
)
df2 = pd.DataFrame({"group": ["Accounting", "Engineering", "HR"], "supervisor": ["Carly", "Guido", "Steve"]})
print(df1)
#   employee        group
# 0      Bob   Accounting
# 1     Jake  Engineering
# 2     Lisa  Engineering
# 3      Sue           HR
print(df2)
#          group supervisor
# 0   Accounting      Carly
# 1  Engineering      Guido
# 2           HR      Steve
df3 = pd.merge(df1, df2)
print(df3)
#   employee        group supervisor
# 0      Bob   Accounting      Carly
# 1     Jake  Engineering      Guido
# 2     Lisa  Engineering      Guido
# 3      Sue           HR      Steve
在supervisor列中有些值会因为输入数据的对应关系而有所重复。 (3)多对多连接 如果左右两个输入的共同列都包含重复值,那么合并的结果就是一种多对多连接。
pythondf1 = pd.DataFrame(
    {"employee": ["Bob", "Jake", "Lisa", "Sue"], "group": ["Accounting", "Engineering", "Engineering", "HR"]}
)
df2 = pd.DataFrame(
    {
        "group": ["Accounting", "Accounting", "Engineering", "Engineering", "HR", "HR"],
        "skills": ["math", "spreadsheets", "coding", "linux", "spreadsheets", "organization"],
    }
)
print(df1)
#   employee        group
# 0      Bob   Accounting
# 1     Jake  Engineering
# 2     Lisa  Engineering
# 3      Sue           HR
print(df2)
#          group        skills
# 0   Accounting          math
# 1   Accounting  spreadsheets
# 2  Engineering        coding
# 3  Engineering         linux
# 4           HR  spreadsheets
# 5           HR  organization
df3 = pd.merge(df1, df2)
print(df3)
#   employee        group        skills
# 0      Bob   Accounting          math
# 1      Bob   Accounting  spreadsheets
# 2     Jake  Engineering        coding
# 3     Jake  Engineering         linux
# 4     Lisa  Engineering        coding
# 5     Lisa  Engineering         linux
# 6      Sue           HR  spreadsheets
# 7      Sue           HR  organization
多对多连接产生的是行的笛卡尔积。由于左边有2个Engineering,右边有2个Engineering,所以最终结果有4个Engineering。 2)设置合并的键与索引 merge()会将两个输入的一个或多个共同列作为键进行合并。但由于两个输入要合并的列通常都不是同名的,因此merge()提供了一些参数处理这个问题。 (1)通过on指定使用某个列连接,只能在有共同列名的时候使用
pythondf1 = pd.DataFrame(
    {"employee": ["Bob", "Jake", "Lisa", "Sue"], "group": ["Accounting", "Engineering", "Engineering", "HR"]}
)
df2 = pd.DataFrame({"employee": ["Lisa", "Bob", "Jake", "Sue"], "hire_date": [2004, 2008, 2012, 2014]})
print(df1)
#   employee        group
# 0      Bob   Accounting
# 1     Jake  Engineering
# 2     Lisa  Engineering
# 3      Sue           HR
print(df2)
#   employee  hire_date
# 0     Lisa       2004
# 1      Bob       2008
# 2     Jake       2012
# 3      Sue       2014
df3 = pd.merge(df1, df2, on="employee")
print(df3)
#   employee        group  hire_date
# 0      Bob   Accounting       2008
# 1     Jake  Engineering       2012
# 2     Lisa  Engineering       2004
# 3      Sue           HR       2014
(2)两对象列名不同,通过left_on和right_on分别指定列名
pythondf1 = pd.DataFrame(
    {"employee": ["Bob", "Jake", "Lisa", "Sue"], "group": ["Accounting", "Engineering", "Engineering", "HR"]}
)
df2 = pd.DataFrame({"name": ["Bob", "Jake", "Lisa", "Sue"], "salary": [70000, 80000, 120000, 90000]})
print(df1)
#   employee        group
# 0      Bob   Accounting
# 1     Jake  Engineering
# 2     Lisa  Engineering
# 3      Sue           HR
print(df2)
#    name  salary
# 0   Bob   70000
# 1  Jake   80000
# 2  Lisa  120000
# 3   Sue   90000
df3 = pd.merge(df1, df2, left_on="employee", right_on="name")
print(df3)
#   employee        group  name  salary
# 0      Bob   Accounting   Bob   70000
# 1     Jake  Engineering  Jake   80000
# 2     Lisa  Engineering  Lisa  120000
# 3      Sue           HR   Sue   90000
(3)通过left_index和right_index设置合并的索引 通过设置merge()中的left_index、right_index参数将索引设置为键来实现合并。
pythondf1 = pd.DataFrame(
    {"employee": ["Bob", "Jake", "Lisa", "Sue"], "group": ["Accounting", "Engineering", "Engineering", "HR"]}
)
df2 = pd.DataFrame({"employee": ["Lisa", "Bob", "Jake", "Sue"], "hire_date": [2004, 2008, 2012, 2014]})
df1.set_index("employee", inplace=True)
df2.set_index("employee", inplace=True)
print(df1)
#                 group
# employee
# Bob        Accounting
# Jake      Engineering
# Lisa      Engineering
# Sue                HR
print(df2)
#           hire_date
# employee
# Lisa           2004
# Bob            2008
# Jake           2012
# Sue            2014
# 设置索引后,如果不指定关联列会报错,建议通过以下方式指定,on="employee"也可#以实现,但是不同的解释器可能效果不一样,因为设置索引后,employee就不算是列了
df3 = pd.merge(df1, df2, left_index=True, right_index=True)
#                 group  hire_date
# employee
# Bob        Accounting       2008
# Jake      Engineering       2012
# Lisa      Engineering       2004
# Sue                HR       2014
DataFrame实现了join()方法,可以按照索引进行数据合并。但要求没有重叠的列,或通过lsuffix、rsuffix指定重叠列的后缀。
pythonimport pandas as pd

df1 = pd.DataFrame({
    'key': ['A', 'B', 'C'],
    'value1': [1, 2, 3]
})

df2 = pd.DataFrame({
    'key': ['B', 'C', 'D'],
    'value2': [4, 5, 6]
})

# 合并两个 DataFrame,并处理列名冲突,如果通过on指定列,只是指定的df1。会用
df1指定的列和df2的索引连接,会报错。除非df2.set_index指定索引。
df1.join(df2,lsuffix='_left',rsuffix='_right')
3)设置数据连接的集合操作规则 当一个值出现在一列,却没有出现在另一列时,就需要考虑集合操作规则了。
pythondf1 = pd.DataFrame({"name": ["Peter", "Paul", "Mary"], "food": ["fish", "beans", "bread"]}, columns=["name", "food"])
df2 = pd.DataFrame({"name": ["Mary", "Joseph"], "drink": ["wine", "beer"]}, columns=["name", "drink"])
print(df1)
#     name   food
# 0  Peter   fish
# 1   Paul  beans
# 2   Mary  bread
print(df2)
#      name drink
# 0    Mary  wine
# 1  Joseph  beer
print(pd.merge(df1, df2))
#    name   food drink
# 0  Mary  bread  wine
合并两个数据集,在name列中只有一个共同的值Mary。默认情况下,结果中只会包含两个输入集合的交集,这种连接方式被称为内连接(inner join)。 我们可以通过how参数设置连接方式,默认值为inner。how参数支持的数据连接方式还有outer、left和right。外连接(outer join)返回两个输入列的并集,所有缺失值都用 NaN 填充。
pythonprint(pd.merge(df1, df2, how="outer"))
#      name   food drink
# 0  Joseph    NaN  beer
# 1    Mary  bread  wine
# 2    Paul  beans   NaN
# 3   Peter   fish   NaN
左连接(left join)和右连接(right join)返回的结果分别只包含左列和右列。
pytonprint(pd.merge(df1, df2, how="left"))
#     name   food drink
# 0  Peter   fish   NaN
# 1   Paul  beans   NaN
# 2   Mary  bread  wine
4)重复列名的处理 可能会遇到两个输入DataFrame有重名列的情况,merge()会自动为其增加后缀_x和_y,也可以通过suffixes参数自定义后缀名。
pythondf1 = pd.DataFrame({"name": ["Bob", "Jake", "Lisa", "Sue"], "rank": [1, 2, 3, 4]})
df2 = pd.DataFrame({"name": ["Bob", "Jake", "Lisa", "Sue"], "rank": [3, 1, 4, 2]})
print(df1)
#    name  rank
# 0   Bob     1
# 1  Jake     2
# 2  Lisa     3
# 3   Sue     4
print(df2)
#    name  rank
# 0   Bob     3
# 1  Jake     1
# 2  Lisa     4
# 3   Sue     2
print(pd.merge(df1, df2, on="name"))  # 不指定后缀名,默认为_x和_y
#    name  rank_x  rank_y
# 0   Bob       1       3
# 1  Jake       2       1
# 2  Lisa       3       4
# 3   Sue       4       2
print(pd.merge(df1, df2, on="name", suffixes=("_df1", "_df2")))  # 通过suffixes指定后缀名
#    name  rank_df1  rank_df2
# 0   Bob         1         3
# 1  Jake         2         1
# 2  Lisa         3         4
# 3   Sue         4         2
7. Padas的缺失值处理函数
7.1 pandas中的缺失值
pandas使用浮点值NaN(Not a Number)表示缺失数据,使用NA(Not Available)表示缺失值。可以通过isnull()、isna()或notnull()、notna()方法判断某个值是否为缺失值。
Nan通常表示一个无效的或未定义的数字值,是浮点数的一种特殊取值,用于表示那些不能表示为正常数字的情况,如 0/0、∞-∞等数学运算的结果。nan与任何值(包括它自身)进行比较的结果都为False。例如在 Python 中,nan == nan返回False。
NA一般用于表示数据不可用或缺失的情况,它的含义更侧重于数据在某种上下文中是缺失或不存在的,不一定特指数字类型的缺失。
na和nan都用于表示缺失值,但nan更强调是数值计算中的特殊值,而na更强调数据的可用性或存在性。
pythons = pd.Series([np.nan, None, pd.NA])
print(s)
# 0     NaN
# 1    None
# 2    <NA>
# dtype: object
print(s.isnull())
# 0    True
# 1    True
# 2    True
# dtype: bool
7.2 加载数据中包含缺失值
pythondf = pd.read_csv("data/weather_withna.csv")
print(df.tail(5))
#             date  precipitation  temp_max  temp_min  wind weather
# 1456  2015-12-27            NaN       NaN       NaN   NaN     NaN
# 1457  2015-12-28            NaN       NaN       NaN   NaN     NaN
# 1458  2015-12-29            NaN       NaN       NaN   NaN     NaN
# 1459  2015-12-30            NaN       NaN       NaN   NaN     NaN
# 1460  2015-12-31           20.6      12.2       5.0   3.8    rain
可以通过keep_default_na参数设置是否将空白值设置为缺失值。
pythondf = pd.read_csv("data/weather_withna.csv", keep_default_na=False)
print(df.tail(5))
#             date precipitation temp_max temp_min wind weather
# 1456  2015-12-27
# 1457  2015-12-28
# 1458  2015-12-29
# 1459  2015-12-30
# 1460  2015-12-31          20.6     12.2      5.0  3.8    rain
可通过na_values参数将指定值设置为缺失值。
pythondf = pd.read_csv("data/weather_withna.csv", na_values=["2015-12-31"])
print(df.tail(5))
#             date  precipitation  temp_max  temp_min  wind weather
# 1456  2015-12-27            NaN       NaN       NaN   NaN     NaN
# 1457  2015-12-28            NaN       NaN       NaN   NaN     NaN
# 1458  2015-12-29            NaN       NaN       NaN   NaN     NaN
# 1459  2015-12-30            NaN       NaN       NaN   NaN     NaN
# 1460         NaN           20.6      12.2       5.0   3.8    rain
7.3 查看缺失值
1)通过isnull()查看缺失值数量
pythondf = pd.read_csv("data/weather_withna.csv")
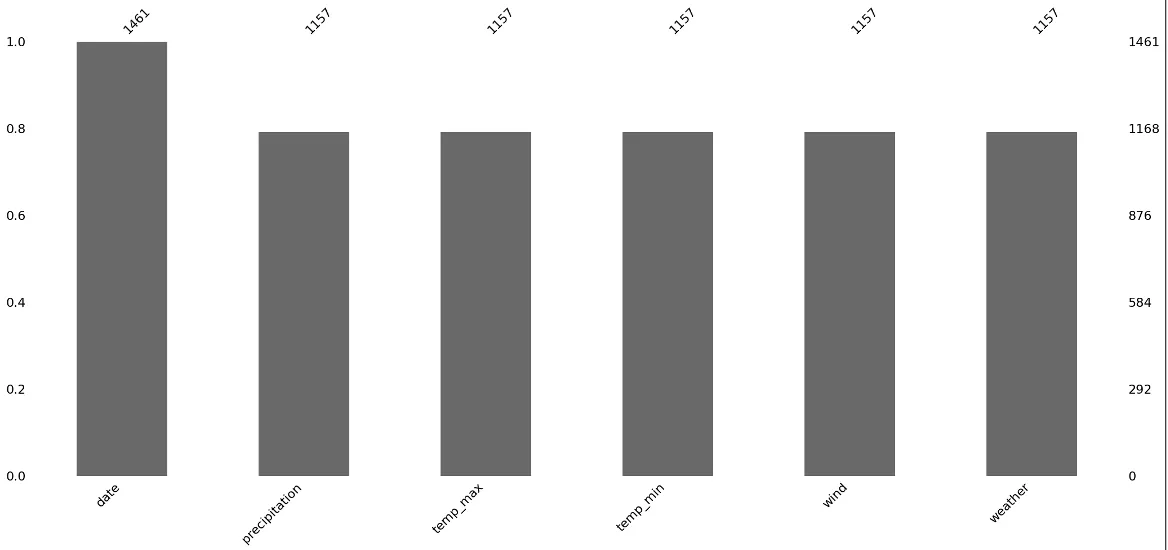
print(df.isnull().sum())
# date               0
# precipitation    303
# temp_max         303
# temp_min         303
# wind             303
# weather          303
# dtype: int64
2)通过missingno条形图展示缺失值 先安装missingno包:pip install missingno
import missingno as msno
import pandas as pd

df = pd.read_csv("data/weather_withna.csv")
msno.bar(df)
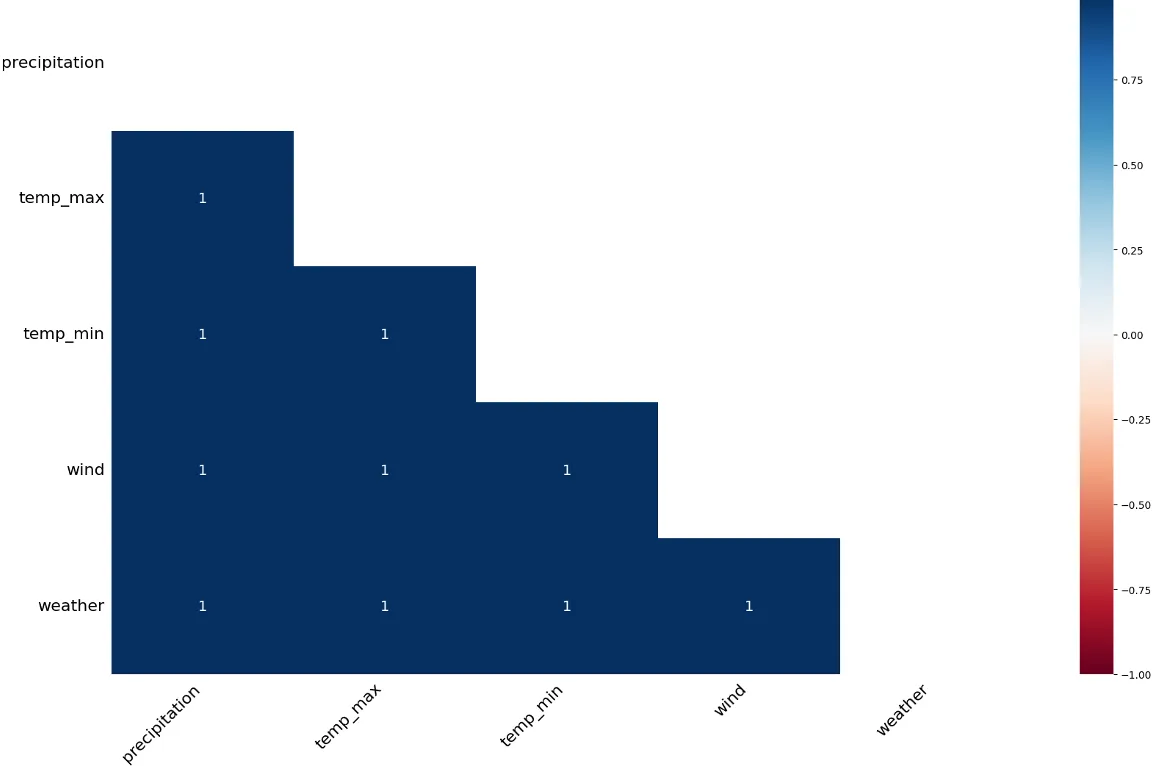
3)通过热力图查看缺失值的相关性 missingno绘制的热力图能够展示数据集中不同列的缺失值之间的相关性。这里的相关性体现的是当某一列出现缺失值时,其他列出现缺失值的可能性。如果两个列的缺失值呈现正相关,意味着当其中一列有缺失值时,另一列也很可能有缺失值;若为负相关,则表示当一列有缺失值时,另一列更倾向于没有缺失值。
- 颜色与数值:热力图中的颜色和数值反映了列之间缺失值的相关性。接近 1 表示正相关,接近 -1 表示负相关,接近 0 则表示缺失值之间没有明显的关联。
- 示例说明:假如 A 列和 B 列在热力图中对应区域颜色较深且数值接近 1,这就表明当 A 列出现缺失值时,B 列也很可能出现缺失值;若数值接近 -1,情况则相反。
msno.heatmap(df)
7.4 剔除缺失值
通过dropna()方法来剔除缺失值。 1)Series剔除缺失值
pythons = pd.Series([1, pd.NA, None])
print(s)
# 0       1
# 1    <NA>
# 2    None
# dtype: object
print(s.dropna())
# 0    1
# dtype: object
2)DataFrame剔除缺失值 无法从DataFrame中单独剔除一个值,只能剔除缺失值所在的整行或整列。默认情况下,dropna()会剔除任何包含缺失值的整行数据。
pythondf = pd.DataFrame([[1, pd.NA, 2], [2, 3, 5], [pd.NA, 4, 6]])
print(df)
#       0     1  2
# 0     1  <NA>  2
# 1     2     3  5
# 2  <NA>     4  6
print(df.dropna())
#    0  1  2
# 1  2  3  5
可以设置按不同的坐标轴剔除缺失值,比如axis=1(或 axis='columns')会剔除任何包含缺失值的整列数据。
pythondf = pd.DataFrame([[1, pd.NA, 2], [2, 3, 5], [pd.NA, 4, 6]])
print(df)
#       0     1  2
# 0     1  <NA>  2
# 1     2     3  5
# 2  <NA>     4  6
print(df.dropna(axis=1))
#    2
# 0  2
# 1  5
# 2  6
有时只需要剔除全部是缺失值的行或列,或者绝大多数是缺失值的行或列。这些需求可以通过设置how或thresh参数来满足,它们可以设置剔除行或列缺失值的数量阈值。
pythondf = pd.DataFrame([[1, pd.NA, 2], [pd.NA, pd.NA, 5], [pd.NA, pd.NA, pd.NA]])
print(df)
#       0     1     2
# 0     1  <NA>     2
# 1  <NA>  <NA>     5
# 2  <NA>  <NA>  <NA>
print(df.dropna(how="all"))  # 如果所有值都是缺失值,则删除这一行
#       0     1  2
# 0     1  <NA>  2
# 1  <NA>  <NA>  5
print(df.dropna(thresh=2))  # 如果至少有2个值不是缺失值,则保留这一行
#    0     1  2
# 0  1  <NA>  2
可以通过设置subset参数来设置某一列有缺失值则进行剔除。
pythondf = pd.DataFrame([[1, pd.NA, 2], [pd.NA, pd.NA, 5], [pd.NA, pd.NA, pd.NA]])
print(df)
#       0     1     2
# 0     1  <NA>     2
# 1  <NA>  <NA>     5
# 2  <NA>  <NA>  <NA>
print(df.dropna(subset=[0]))  # 如果0列有缺失值,则删除这一行
#    0     1  2
# 0  1  <NA>  2
7.5 填充缺失值
1)使用固定值填充 通过fillna()方法,传入值或字典进行填充。
pythondf = pd.read_csv("data/weather_withna.csv")
print(df.fillna(0).tail())  # 使用固定值填充
#             date  precipitation  temp_max  temp_min  wind weather
# 1456  2015-12-27            0.0       0.0       0.0   0.0       0
# 1457  2015-12-28            0.0       0.0       0.0   0.0       0
# 1458  2015-12-29            0.0       0.0       0.0   0.0       0
# 1459  2015-12-30            0.0       0.0       0.0   0.0       0
# 1460  2015-12-31           20.6      12.2       5.0   3.8    rain
print(df.fillna({"temp_max": 60, "temp_min": -60}).tail())  # 使用字典来填充
#             date  precipitation  temp_max  temp_min  wind weather
# 1456  2015-12-27            NaN      60.0     -60.0   NaN     NaN
# 1457  2015-12-28            NaN      60.0     -60.0   NaN     NaN
# 1458  2015-12-29            NaN      60.0     -60.0   NaN     NaN
# 1459  2015-12-30            NaN      60.0     -60.0   NaN     NaN
# 1460  2015-12-31           20.6      12.2       5.0   3.8    rain
2)使用统计值填充 通过fillna()方法,传入统计后的值进行填充。
pythonprint(df.fillna(df[["precipitation", "temp_max", "temp_min", "wind"]].mean()).tail())  # 使用平均值填充
#             date  precipitation   temp_max  temp_min      wind weather
# 1456  2015-12-27       3.052332  15.851468  7.877202  3.242055     NaN
# 1457  2015-12-28       3.052332  15.851468  7.877202  3.242055     NaN
# 1458  2015-12-29       3.052332  15.851468  7.877202  3.242055     NaN
# 1459  2015-12-30       3.052332  15.851468  7.877202  3.242055     NaN
# 1460  2015-12-31      20.600000  12.200000  5.000000  3.800000    rain
3)使用前后的有效值填充 通过ffill()或bfill()方法使用前面或后面的有效值填充。
pythonprint(df.ffill().tail())  # 使用前面的有效值填充
#             date  precipitation  temp_max  temp_min  wind weather
# 1456  2015-12-27            0.0      11.1       4.4   4.8     sun
# 1457  2015-12-28            0.0      11.1       4.4   4.8     sun
# 1458  2015-12-29            0.0      11.1       4.4   4.8     sun
# 1459  2015-12-30            0.0      11.1       4.4   4.8     sun
# 1460  2015-12-31           20.6      12.2       5.0   3.8    rain
print(df.bfill().tail())  # 使用后面的有效值填充
#             date  precipitation  temp_max  temp_min  wind weather
# 1456  2015-12-27           20.6      12.2       5.0   3.8    rain
# 1457  2015-12-28           20.6      12.2       5.0   3.8    rain
# 1458  2015-12-29           20.6      12.2       5.0   3.8    rain
# 1459  2015-12-30           20.6      12.2       5.0   3.8    rain
# 1460  2015-12-31           20.6      12.2       5.0   3.8    rain
4)通过线性插值填充 通过interpolate()方法进行线性插值填充。线性插值操作,就是用于在已知数据点之间估算未知数据点的值。interpolate 方法支持多种插值方法,可通过 method 参数指定,常见的方法有:
- 'linear':线性插值,基于两点之间的直线来估算缺失值,适用于数据呈线性变化的情况。
- 'time':适用于时间序列数据,会考虑时间间隔进行插值。
- 'polynomial':多项式插值,通过拟合多项式曲线来估算缺失值,可通过 order 参数指定多项式的阶数。
pythonimport pandas as pd
import numpy as np

# 创建包含缺失值的 Series
s = pd.Series([1, np.nan, 3, 4, np.nan, 6])
# 使用默认的线性插值方法填充缺失值
s_interpolated = s.interpolate()
print(s_interpolated)

# 0    1.0
# 1    2.0
# 2    3.0
# 3    4.0
# 4    5.0
# 5    6.0
# dtype: float64
8. Padas的apply函数
apply()函数可以对DataFrame或Series的数据进行逐行、逐列或逐元素的操作。可以使用自定义函数对数据进行变换、计算或处理,通常用于处理复杂的变换逻辑,或者处理不能通过向量化操作轻松完成的任务。
8.1 Series使用apply()
pythonimport pandas as pd
# Series的apply方法调用的函数,参数接收的是Series中的一个元素
def func(item):
    return item * 20

s = pd.Series([10, 20, 30])
s.apply(func)
也可以传入lambda表达式。
pythons.apply(lambda item: item * 20)
传入带参数的函数。
python# apply()方法会将自己没有匹配上的参数,在调用func的时候作为func的参数传递过去,必须通过关键字传参
def func1(item,p1):
    return item * p1
s.apply(func1,p1=3)
8.2 DataFrame使用apply()
python# DataFrame的apply方法调用的函数,参数接收的是DataFrame中的一个Series
def func(s):
    return s.sum()

df = pd.DataFrame({"a": [10, 20, 30], "b": [40, 50, 60]})
df.apply(func)

#默认axis=0,按行方向进行操作,对列进行统计;
#可以设置axis=1,按照列的方向进行操作,对行进行统计
df.apply(func, axis=1)
注意:df.apply 一次只能处理一个 Series(当 axis=0 时处理列,当 axis=1 时处理行),但如下的函数 func中,获取同一个Series对象的两列数据a和b,所以不能直接使用 df.apply(f)按列处理了,需要指定axis=1,按行处理,才能获取一行中的不同列。
pythondef func(s):
    return s["a"] / s["b"]

df = pd.DataFrame({"a": [10, 20, 30], "b": [40, 50, 60]})
print(df.apply(func, axis=1))
# 0    0.25
# 1    0.40
# 2    0.50
# dtype: float64
8.3 向量化函数
pythondef f(x, y):
    if y == 0:
        return np.nan
    return x / y

df = pd.DataFrame({"a": [10, 20, 30], "b": [40, 0, 60]})
print(f(df["a"], df["b"]))  # ValueError
上述代码会报错,因为y==0中,y为向量而0为标量。 (1)可以通过np.vectorize()将函数向量化来进行计算
pythondef f(x, y):
    if y == 0:
        return np.nan
    return x / y

df = pd.DataFrame({"a": [10, 20, 30], "b": [40, 0, 60]})
f_vec = np.vectorize(f)
print(f_vec(df["a"], df["b"]))  # [0.25  nan 0.5 ]
(2)也可以使用@np.vectorize装饰器将函数向量化
python@np.vectorize
def f(x, y):
    if y == 0:
        return np.nan
    return x / y

df = pd.DataFrame({"a": [10, 20, 30], "b": [40, 0, 60]})
print(f(df["a"], df["b"]))  # [0.25  nan 0.5 ]
9. Padas的数据聚合、转换、过滤函数
9.1 DataFrameGroupBy对象
对DataFrame对象调用groupby()方法后,会返回DataFrameGroupBy对象。
pythondf = pd.read_csv("data/employees.csv")  # 读取员工数据
print(df.groupby("department_id"))  # 按department_id分组,返回DataFrameGroupBy对象
# <pandas.core.groupby.generic.DataFrameGroupBy object at 0x0000024FCBAFD700>
这个对象可以看成是一种特殊形式的 DataFrame,里面隐藏着若干组数据,但是在没有应用累计函数之前不会计算。GroupBy对象是一种非常灵活的抽象类型。在大多数场景中,可以将它看成是DataFrame的集合。 1)查看分组 通过groups属性查看分组结果,返回一个字典,字典的键是分组的标签,值是属于该组的所有索引的列表。
pythonprint(df.groupby("department_id").groups)  # 查看分组结果
# {10.0: [100], 20.0: [101, 102], 30.0: [14, 15, 16, 17, 18, 19]...
通过get_group()方法获取分组。
pythonprint(df.groupby("department_id").get_group(50))  # 获取分组为50的数据
#     employee_id first_name    last_name     email...
# 20          120    Matthew        Weiss    MWEISS...
# 21          121       Adam        Fripp    AFRIPP...
# 22          122      Payam     Kaufling  PKAUFLIN...
2)按列取值
pythonprint(df.groupby("department_id")["salary"])  # 按department_id分组,取salary列
# <pandas.core.groupby.generic.SeriesGroupBy object at 0x0000022456D6F2F0>
这里从原来的DataFrame中取某个列名作为一个Series组。与GroupBy对象一样,直到我们运行累计函数,才会开始计算。
pythonprint(df.groupby("department_id")["salary"].mean())  # 计算每个部门平均薪资
# department_id
# 10.0      4400.000000
# 20.0      9500.000000
# 30.0      4150.000000
3)按组迭代 GroupBy对象支持直接按组进行迭代,返回的每一组都是Series或DataFrame。
pythonfor dept_id,group in df.groupby("department_id"):
    print(f"当前组为{dept_id},组里的数据情况{group.shape}:")
    print(group.iloc[:,0:3])
    print("-------------------")
# 当前组为10.0,组里的数据情况(1, 10):
#      employee_id first_name last_name
# 100          200   Jennifer    Whalen
# -------------------
# 当前组为20.0,组里的数据情况(2, 10):
#      employee_id first_name  last_name
# 101          201    Michael  Hartstein
# 102          202        Pat        Fay
...
4)按多字段分组
pythonsalary_mean = df.groupby(["department_id", "job_id"])[
    ["salary", "commission_pct"]
].mean()  # 按department_id和job_id分组
print(salary_mean.index)  # 查看分组后的索引
# MultiIndex([( 10.0,    'AD_ASST'),
#             ( 20.0,     'MK_MAN'),
#             ( 20.0,     'MK_REP'),
#             ( 30.0,   'PU_CLERK'),
#             ( 30.0,     'PU_MAN'),
#             ...
print(salary_mean.columns)  # 查看分组后的列
# Index(['salary', 'commission_pct'], dtype='object')
按多个字段分组后得到的索引为复合索引。 可通过reset_index()方法重置索引。
pythonprint(salary_mean.reset_index())
#     department_id      job_id        salary  commission_pct
# 0            10.0     AD_ASST   4400.000000             NaN
# 1            20.0      MK_MAN  13000.000000             NaN
# 2            20.0      MK_REP   6000.000000             NaN
# 3            30.0    PU_CLERK   2780.000000             NaN
# 4            30.0      PU_MAN  11000.000000             NaN
也可以在分组的时候通过as_index = False参数(默认是True)重置索引。
pythonsalary_mean = df.groupby(["department_id", "job_id"], as_index=False)[
    ["salary", "commission_pct"]
].mean()  # 按department_id和job_id分组
print(salary_mean)
#     department_id      job_id        salary  commission_pct
# 0            10.0     AD_ASST   4400.000000             NaN
# 1            20.0      MK_MAN  13000.000000             NaN
# 2            20.0      MK_REP   6000.000000             NaN
# 3            30.0    PU_CLERK   2780.000000             NaN
# 4            30.0      PU_MAN  11000.000000             NaN
5)cut() pandas.cut()用于将连续数据(如数值型数据)分割成离散的区间。可以使用cut()来将数据划分为不同的类别或范围,通常用于数据的分箱处理。 cut()部分参数说明:
| 参数 | 说明 |
|---|---|
x | 要分箱的数组或 Series,通常是数值型数据 |
bins | 切分区间的数值列表或者整数。・传整数 n:将数据均匀分成 n 个区间・传列表:手动指定区间边界 |
right | 默认True,区间右闭 (a,b],包含右端点;False则左闭 [a,b),包含左端点 |
labels | 传入列表,给每个区间设置自定义标签;不传则默认返回区间字符串 |
pythondf = pd.read_csv("data/employees.csv")  # 加载员工数据

salary = pd.cut(df.iloc[9:16]["salary"], 3)
print(salary)
# 9      (8366.667, 11000.0]
# 10    (5733.333, 8366.667]
# 11    (5733.333, 8366.667]
# 12    (5733.333, 8366.667]
# 13    (5733.333, 8366.667]
# 14     (8366.667, 11000.0]
# 15      (3092.1, 5733.333]
# Name: salary, dtype: category
# Categories (3, interval[float64, right]): [(3092.1, 5733.333] < (5733.333, 8366.667] <
#                                            (8366.667, 11000.0]]

salary = pd.cut(df.iloc[9:16]["salary"], [0, 10000, 20000])
print(salary)
# 9         (0, 10000]
# 10        (0, 10000]
# 11        (0, 10000]
# 12        (0, 10000]
# 13        (0, 10000]
# 14    (10000, 20000]
# 15        (0, 10000]
# Name: salary, dtype: category
# Categories (2, interval[int64, right]): [(0, 10000] < (10000, 20000]]

salary = pd.cut(df.iloc[9:16]["salary"], 3, labels=["low", "medium", "high"])
print(salary)
# 9       high
# 10    medium
# 11    medium
# 12    medium
# 13    medium
# 14      high
# 15       low
# Name: salary, dtype: category
# Categories (3, object): ['low' < 'medium' < 'high']
9.2 分组聚合
df.groupby("分组字段")["要聚合的字段"].聚合函数() df.groupby(["分组字段", "分组字段2", ...])[["要聚合的字段", "要聚合的字段2", ...]].聚合函数() 1)常用聚合函数
| 方法 | 说明 |
|---|---|
sum() | 分组求和,自动忽略缺失值 NaN |
mean() | 分组求平均值,忽略 NaN |
min() | 分组最小值 |
max() | 分组最大值 |
var() | 分组方差(样本方差) |
std() | 分组标准差 |
median() | 分组中位数 |
quantile() | 指定分位数,quantile(0.5)等价中位数 |
describe() | 分组统计摘要:count、mean、std、min、四分位数、max |
size() | 每组所有元素行数(包含 NaN,统计每组有多少条记录) |
count() | 每组非空元素数量(每列,不计 NaN) |
first() | 取每组的第一行数据 |
last() | 取每组的最后一行数据 |
nth(n) | 取每组的第 n 行,n 从 0 开始 |
2)一次计算多个统计值 可以通过agg()或aggregate()进行更复杂的操作,如一次计算多个统计值。
pythondf = pd.read_csv("data/employees.csv")  # 读取员工数据
# 按department_id分组,计算salary的最小值,中位数,最大值
print(df.groupby("department_id")["salary"].agg(["min", "median", "max"]))
#                    min   median      max
# department_id
# 10.0            4400.0   4400.0   4400.0
# 20.0            6000.0   9500.0  13000.0
# 30.0            2500.0   2850.0  11000.0
# 40.0            6500.0   6500.0   6500.0
# 50.0            2100.0   3100.0   8200.0
3)多个列计算不同的统计值 也可以在agg()中传入字典,对多个列计算不同的统计值。
pythondf = pd.read_csv("data/employees.csv")  # 读取员工数据
# 按department_id分组,统计job_id的种类数,commission_pct的平均值
print(df.groupby("department_id").agg({"job_id": "nunique", "commission_pct": "mean"}))
#                job_id  commission_pct
# department_id
# 10.0                1             NaN
# 20.0                2             NaN
# 30.0                2             NaN
# 40.0                1             NaN
# 50.0                3             NaN
4)重命名统计值 可以在agg()后通过rename()对统计后的列重命名。
pythondf = pd.read_csv("data/employees.csv")  # 读取员工数据
# 按department_id分组,统计job_id的种类数,commission_pct的平均值
print(
    df.groupby("department_id")
    .agg(
        {"job_id": "nunique", "commission_pct": "mean"},
    )
    .rename(
        columns={"job_id": "工种数", "commission_pct": "佣金比例平均值"},
    )
)
#                工种数  佣金比例平均值
# department_id
# 10.0             1      NaN
# 20.0             2      NaN
# 30.0             2      NaN
# 40.0             1      NaN
# 50.0             3      NaN
5)自定义函数 可以向agg()中传入自定义函数进行计算。
pythondf = pd.read_csv("data/employees.csv")  # 读取员工数据

def f(x):
"""统计每个部门员工last_name的首字母"""
    result = set()
    for i in x:
        result.add(i[0])
    return result

print(df.groupby("department_id")["last_name"].agg(f))
# department_id
# 10.0                                                   {W}
# 20.0                                                {F, H}
# 30.0                                    {B, T, R, C, K, H}
# 40.0                                                   {M}
# 50.0     {O, E, K, S, W, L, P, D, C, V, B, T, M, J, F, ...
注意:函数中的df.groupby("department_id")返回的DataFrameGroupBy可以理解为多个组对应的DataFrame的集合。df.groupby("department_id")["last_name"]返回的SeriesGroupBy可以理解为多个组对应的series集合。所以在使用agg或者后面的transform、filter对数据进行处理的时候,传递给自定义函数的参数是一个Series
9.3 分组转换
聚合操作返回的是对组内全量数据缩减过的结果,而转换操作会返回一个新的全量数据。数据经过转换之后,其形状与原来的输入数据是一样的。 1)通过transform()将每一组的样本数据减去各组的均值,实现数据标准化
pythondf = pd.read_csv("data/employees.csv")  # 读取员工数据
print(df.groupby("department_id")["salary"].transform(lambda x: x - x.mean()))
# 0      4666.666667
# 1     -2333.333333
# 2     -2333.333333
# 3      3240.000000
# 4       240.000000
2)通过transform()按分组使用平均值填充缺失值
pythondf = pd.read_csv("data/employees.csv")  # 读取员工数据
na_index = pd.Series(df.index.tolist()).sample(30)  # 随机挑选30条数据
df.loc[na_index, "salary"] = pd.NA  # 将这30条数据的salary设置为缺失值
print(df.groupby("department_id")["salary"].agg(["size", "count"]))  # 查看每组数据总数与非空数据数

def fill_missing(x):
    # 使用平均值填充,如果平均值也为NaN,用0填充
    if np.isnan(x.mean()):
        return 0
    return x.fillna(x.mean())

df["salary"] = df.groupby("department_id")["salary"].transform(fill_missing)
print(df.groupby("department_id")["salary"].agg(["size", "count"]))  # 查看每组数据总数与非空数据数
9.4 分组过滤
过滤操作可以让我们按照分组的属性丢弃若干数据。 例如,我们可能只需要保留commission_pct不包含空值的分组的数据。
pythoncommission_pct_filter = df.groupby("department_id").filter(
    lambda x: x["commission_pct"].notnull().all()
)  # 按department_id分组,过滤掉commission_pct包含空值的分组
print(commission_pct_filter)
10 Pandas透视表
10.1 什么是透视表
透视表(pivot table)是各种电子表格程序和其他数据分析软件中一种常见的数据汇总工具。它可以根据多个行分组键和多个列分组键对数据进行聚合,并根据行和列上的分组键将数据分配到各个矩形区域中。
10.2 pivot_table()
pandas中提供了DataFrame.pivot_table()和pandas.pivot_table()方法来生成透视表。两者的区别是pandas.pivot_table()需要额外传入一个data参数指定对哪个DataFrame进行处理。 pivot_table()的参数如下:
| 参数 | 说明 |
|---|---|
values | 待聚合的列,默认聚合所有数值列 |
index | 用作透视表行索引的列;用来分组,决定透视表行维度,可以传多个列(列表) |
columns | 用作透视表列索引的列;决定透视表列维度,可以传多个列(列表) |
aggfunc | 聚合函数 / 函数列表,默认是 mean(求均值),可以sum/max/min等,支持传入列表一次性多个聚合 |
fill_value | 填充透视表里产生的缺失值(NaN) |
margins | 是否增加总计行、总计列。默认False;margins=True会多出 “All” 汇总行列 |
dropna | 是否剔除全部为空的行 / 列。默认True,删除全缺失的组合;False保留 |
observed | 针对分类变量。True:只展示实际存在的分组组合,不生成笛卡尔积的空组合;False展示全部可能组合。 |
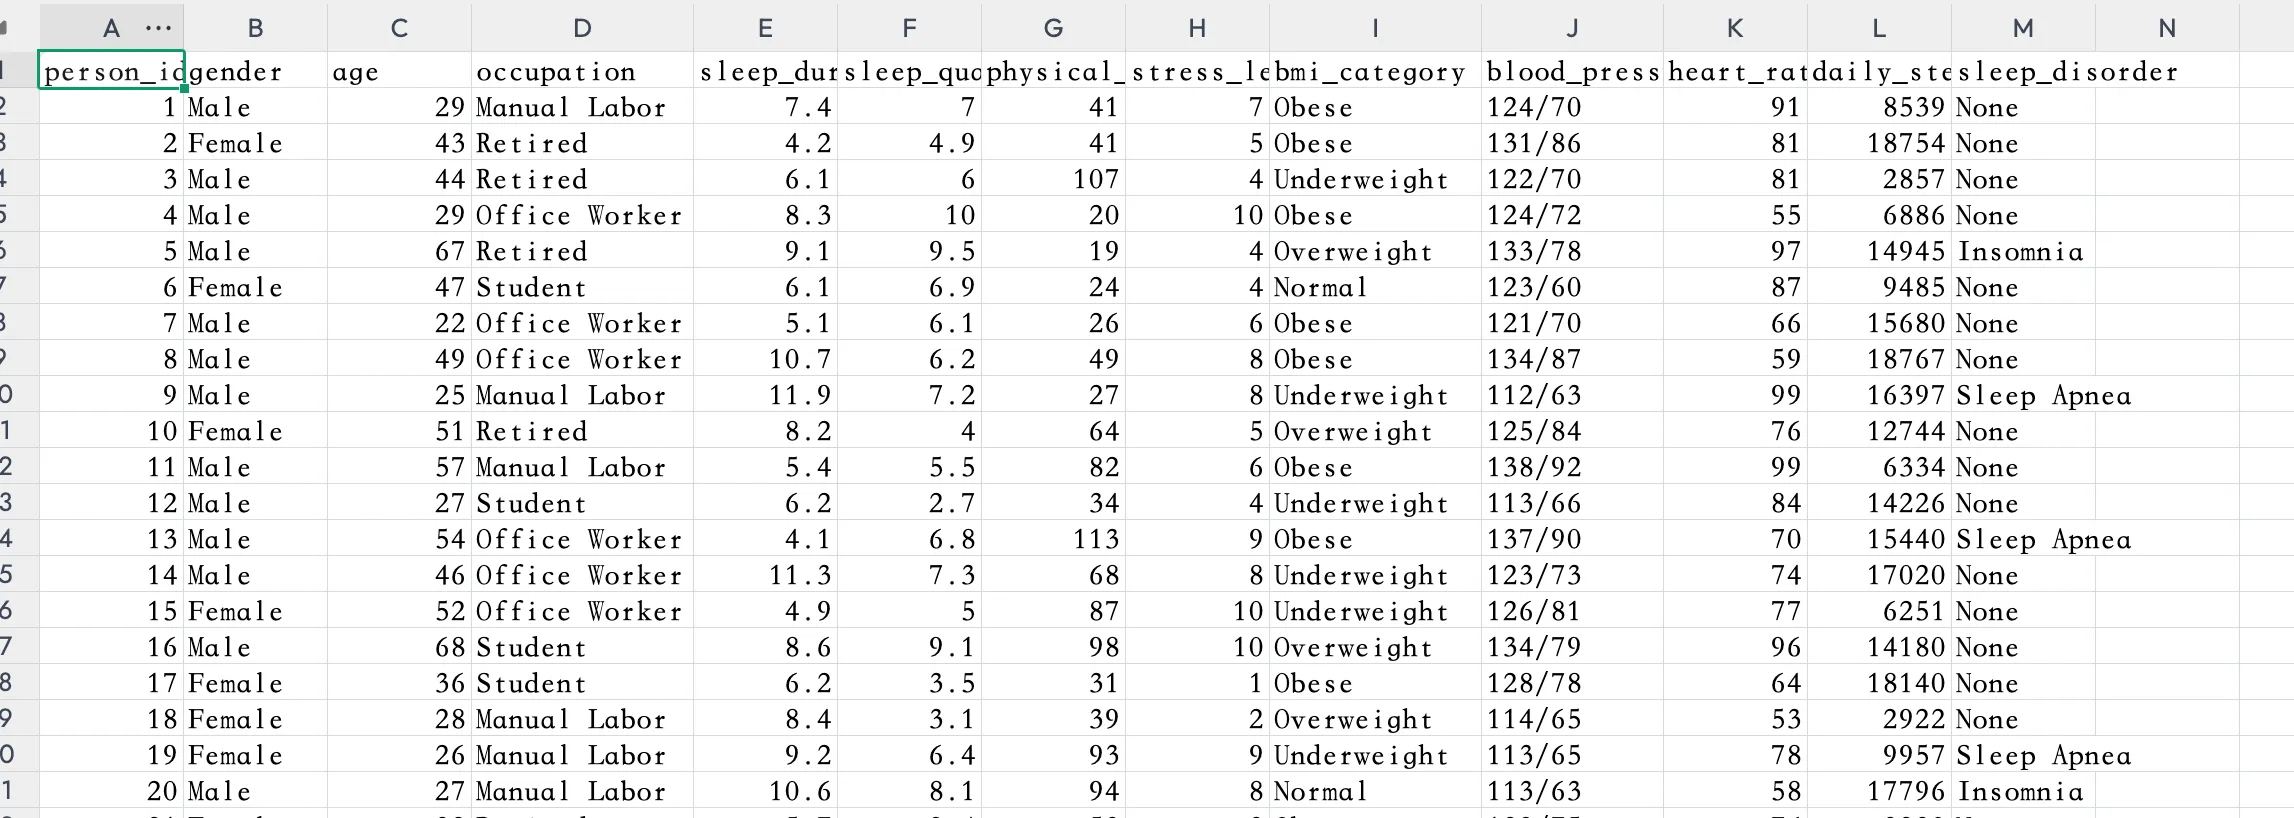
10.3 案例:睡眠质量分析透视表
使用sleep(睡眠健康和生活方式)数据集,其中包含13个字段:
- person_id:每个人的唯一标识符。
- gender:个人的性别(男/女)。
- age:个人的年龄(以岁为单位)。
- occupation:个人的职业或就业状况(例如办公室职员、体力劳动者、学生)。
- sleep_duration:每天的睡眠总小时数。
- sleep_quality:睡眠质量的主观评分,范围从 1(差)到 10(极好)。
- physical_activity_level:每天花费在体力活动上的时间(以分钟为单位)。
- stress_level:压力水平的主观评级,范围从 1(低)到 10(高)。
- bmi_category:个人的 BMI 分类(体重过轻、正常、超重、肥胖)。
- blood_pressure:血压测量,显示为收缩压与舒张压的数值。
- heart_rate:静息心率,以每分钟心跳次数为单位。
- daily_steps:个人每天行走的步数。
- sleep_disorder:存在睡眠障碍(无、失眠、睡眠呼吸暂停)。
 1)统计不同睡眠时间,不同压力等级下的睡眠质量
pythondf = pd.read_csv("data/sleep.csv")
sleep_duration_stage = pd.cut(df["sleep_duration"], [0, 5, 6, 7, 8, 9, 10, 11, 12])  # 对睡眠时间进行划分
stress_level_stage = pd.cut(df["stress_level"], 4)  # 对压力等级进行划分
print(df.pivot_table(values="sleep_quality", index=[sleep_duration_stage, stress_level_stage], aggfunc="mean"))
#                               sleep_quality
# sleep_duration stress_level
# (0, 5]         (0.991, 3.25]       6.781818
#                (3.25, 5.5]         6.161538
#                (5.5, 7.75]         5.677778
#                (7.75, 10.0]        6.082353
# (5, 6]         (0.991, 3.25]       5.876923
#                (3.25, 5.5]         6.777778
#                (5.5, 7.75]         6.058333
#                (7.75, 10.0]        6.438462
2)添加职业作为列维度
pythonprint(
    df.pivot_table(
        values="sleep_quality", index=[sleep_duration_stage, stress_level_stage], columns=["occupation"], aggfunc="mean"
    )
)
# occupation                    Manual Labor  Office Worker   Retired   Student
# sleep_duration stress_level
# (0, 5]         (0.991, 3.25]      6.900000       6.350000  6.720000  6.750000
#                (3.25, 5.5]        3.300000       7.966667  6.060000  5.650000
#                (5.5, 7.75]        4.833333       6.900000  3.200000  6.533333
#                (7.75, 10.0]       7.200000       5.977778  5.225000  7.150000
# (5, 6]         (0.991, 3.25]      5.220000       6.433333  5.700000  6.533333
#                (3.25, 5.5]        5.000000       7.050000  6.900000  9.000000
#                (5.5, 7.75]        6.050000       5.300000  5.300000  7.200000
#                (7.75, 10.0]       6.475000       4.050000       NaN  7.100000
3)添加性别作为第二个列维度
pythonprint(
    df.pivot_table(
        values="sleep_quality",
        index=[sleep_duration_stage, stress_level_stage],
        columns=["occupation", "gender"],
        aggfunc="mean",
    )
)
# occupation                   Manual Labor           Office Worker          Retired              Student
# gender                             Female      Male        Female   Male    Female       Male    Female      Male
# sleep_duration stress_level
# (0, 5]         (0.991, 3.25]         6.75  7.300000      6.700000  6.000       NaN   6.720000  6.100000  7.400000
#                (3.25, 5.5]           3.30       NaN      7.100000  9.700  4.850000   6.866667  5.300000  6.700000
#                (5.5, 7.75]           4.55  5.400000      5.900000  7.900       NaN   3.200000  6.850000  5.900000
#                (7.75, 10.0]          8.40  6.000000      5.180000  6.975  6.600000   4.766667  7.150000       NaN
# (5, 6]         (0.991, 3.25]         5.50  4.800000      8.200000  5.550  5.700000        NaN  8.150000  3.300000
#                (3.25, 5.5]           5.00       NaN      6.600000  7.500  6.700000   7.100000  9.000000       NaN
#                (5.5, 7.75]           6.60  5.500000      4.900000  6.100  4.450000   7.000000  7.066667  7.600000
#                (7.75, 10.0]          6.15  6.800000           NaN  4.050       NaN        NaN  7.266667  6.975000
11. Pandas时间序列
11.1 Python中的日期与时间工具
Python基本的日期与时间功能都在标准库的datetime模块中。
pythonfrom datetime import datetime

date1 = datetime(year=2000, month=1, day=1)
date2 = datetime.now()
print(date1)  # 2000-01-01 00:00:00
print(date2)  # 2025-01-01 00:00:00
print(date1.year)  # 2000
print(date1.month)  # 1
print(date1.day)  # 1
print(date2.weekday())  # 5
print(date2.strftime("%A"))  # Saturday
print(date2 - date1)  # 18263 days, 0:00:00
11.2 pandas中的日期与时间
pandas的日期时间类型默认是datetime64[ns]。
- 针对时间戳数据,pandas提供了Timestamp类型。它本质上是Python原生datetime类型的替代品,但是在性能更好的numpy.datetime64类型的基础上创建。对应的索引数据结构是DatetimeIndex。
- 针对时间周期数据,pandas提供了Period类型。这是利用numpy.datetime64类型将固定频率的时间间隔进行编码。对应的索引数据结构是PeriodIndex。
- 针对时间增量或持续时间,pandas提供了Timedelta类型。Timedelta是一种代替Python原生datetime.timedelta类型的高性能数据结构,同样是基于numpy.timedelta64类型。对应的索引数据结构是TimedeltaIndex。
1)datetime64 to_datetime()可以解析许多日期与时间格式。对to_datetime()传递一个日期会返回一个Timestamp类型,传递一个时间序列会返回一个DatetimeIndex类型。
注意:Timestamp 是 pandas 对 datetime64 数据类型的一个封装。datetime64 是 NumPy 中的一种数据类型,用于表示日期和时间,而 pandas 基于 datetime64 构建了 Timestamp 类,以便更方便地在 pandas 的数据结构(如 DataFrame 和 Series)中处理日期时间数据。当 pd.to_datetime 接收单个日期时间值时,会返回 Timestamp 对象。不过,要是使用 dtype 属性查看,得到的却是 datetime64[ns],这是因为 dtype 反映的是底层存储的数据类型,而 Timestamp 对象底层存储的数据类型就是 datetime64[ns]。
pythonprint(pd.to_datetime("2015-01-01"))
# 2015-01-01 00:00:00
print(pd.to_datetime(["4th of July, 2015", "2015-Jul-6", "07-07-2015", "20150708"], format="mixed"))
# DatetimeIndex(['2015-07-04', '2015-07-06', '2015-07-07', '2015-07-08'], dtype='datetime64[ns]', freq=None)
在加载数据时,可以通过to_datetime()将数据中的列解析为datetime64。
df = pd.read_csv("data/weather.csv")
print(df["date"].tail())
# 1456    2015-12-27
# 1457    2015-12-28
# 1458    2015-12-29
# 1459    2015-12-30
# 1460    2015-12-31
# Name: date, dtype: object
print(pd.to_datetime(df["date"]).tail())
# 1456   2015-12-27
# 1457   2015-12-28
# 1458   2015-12-29
# 1459   2015-12-30
# 1460   2015-12-31
# Name: date, dtype: datetime64[ns]
在加载数据时也可以通过parse_dates参数将指定列解析为datetime64。
df = pd.read_csv("data/weather.csv", parse_dates=[0])
print(df["date"].tail())
# 1456   2015-12-27
# 1457   2015-12-28
# 1458   2015-12-29
# 1459   2015-12-30
# 1460   2015-12-31
# Name: date, dtype: datetime64[ns]
2)提取日期的各个部分 (1)提取Timestamp
d = pd.Timestamp("2015-01-01 09:08:07.123456")
print(d.year)  # 2015
print(d.month)  # 1
print(d.day)  # 1
print(d.hour)  # 9
print(d.minute)  # 8
print(d.second)  # 7
print(d.microsecond)  # 123456
(2)对于Series对象,需要使用dt访问器
df = pd.read_csv("data/weather.csv", parse_dates=[0])
df_date = pd.to_datetime(df["date"])
df["year"] = df_date.dt.year
df["month"] = df_date.dt.month
df["day"] = df_date.dt.day
print(df[["date", "year", "month", "day"]].tail())
#            date  year  month  day
# 1456 2015-12-27  2015     12   27
# 1457 2015-12-28  2015     12   28
# 1458 2015-12-29  2015     12   29
# 1459 2015-12-30  2015     12   30
# 1460 2015-12-31  2015     12   31
3)period 可以通过to_period()方法和一个频率代码将datetime64类型转换成period类型。
df = pd.read_csv("data/weather.csv")
df["quarter"] = pd.to_datetime(df["date"]).dt.to_period("Q")  # 将 年-月-日 转换为 年季度
print(df[["date", "quarter"]].head())
#          date quarter
# 0  2012-01-01  2012Q1
# 1  2012-01-02  2012Q1
# 2  2012-01-03  2012Q1
# 3  2012-01-04  2012Q1
# 4  2012-01-05  2012Q1
4)timedelta64 当用一个日期减去另一个日期,返回的结果是timedelta64类型。
df = pd.read_csv("data/weather.csv", parse_dates=[0])
df_date = pd.to_datetime(df["date"])
timedelta = df_date - df_date[0]
print(timedelta.head())
# 0   0 days
# 1   1 days
# 2   2 days
# 3   3 days
# 4   4 days
# Name: date, dtype: timedelta64[ns]
11.3 使用时间作为索引
1)DatetimeIndex 将datetime64类型的数据设置为索引,得到的就是DatetimeIndex。
df = pd.read_csv("data/weather.csv")
df["date"] = pd.to_datetime(df["date"])  # 将date列转换为datetime64类型
df.set_index("date", inplace=True)  # 将date列设置为索引
df.info()
# <class 'pandas.core.frame.DataFrame'>
# DatetimeIndex: 1461 entries, 2012-01-01 to 2015-12-31
将时间作为索引后可以直接使用时间进行切片取值。
print(df.loc["2013-01":"2013-06"])  # 获取2013年1~6月的数据
#             precipitation  temp_max  temp_min  wind weather
# date
# 2013-01-01            0.0       5.0      -2.8   2.7     sun
# 2013-01-02            0.0       6.1      -1.1   3.2     sun
# ...                   ...       ...       ...   ...     ...
# 2013-06-29            0.0      30.0      18.3   1.7     sun
# 2013-06-30            0.0      33.9      17.2   2.5     sun
print(df.loc["2015"])  # 获取2015年所有数据
#             precipitation  temp_max  temp_min  wind weather
# date
# 2015-01-01            0.0       5.6      -3.2   1.2     sun
# 2015-01-02            1.5       5.6       0.0   2.3    rain
# ...                   ...       ...       ...   ...     ...
# 2015-12-30            0.0       5.6      -1.0   3.4     sun
# 2015-12-31            0.0       5.6      -2.1   3.5     sun
也可以通过between_time()和at_time()获取某些时刻的数据。
df.between_time("9:00", "11:00")  # 获取9:00到11:00之间的数据
df.at_time("3:33")  # 获取3:33的数据
2)TimedeltaIndex 将timedelta64类型的数据设置为索引,得到的就是TimedeltaIndex。
df = pd.read_csv("data/weather.csv", parse_dates=[0])
df_date = pd.to_datetime(df["date"])
df["timedelta"] = df_date - df_date[0]  # 得到timedelta64类型的数据
df.set_index("timedelta", inplace=True)  # 将timedelta列设置为索引
df.info()
# <class 'pandas.core.frame.DataFrame'>
# TimedeltaIndex: 1461 entries, 0 days to 1460 days
将时间作为索引后可以直接使用时间进行切片取值。
print(df.loc["0 days":"5 days"])
#                 date  precipitation  temp_max  temp_min  wind  weather
# timedelta
# 0 days    2012-01-01            0.0      12.8       5.0   4.7  drizzle
# 1 days    2012-01-02           10.9      10.6       2.8   4.5     rain
# 2 days    2012-01-03            0.8      11.7       7.2   2.3     rain
# 3 days    2012-01-04           20.3      12.2       5.6   4.7     rain
# 4 days    2012-01-05            1.3       8.9       2.8   6.1     rain
# 5 days    2012-01-06            2.5       4.4       2.2   2.2     rain
11.4 生成时间序列
为了能更简便地创建有规律的时间序列,pandas提供了date_range()方法。 1)date_range() date_range()通过开始日期、结束日期和频率代码(可选)创建一个有规律的日期序列,默认的频率是天。
print(pd.date_range("2015-07-03", "2015-07-10"))
# DatetimeIndex(['2015-07-03', '2015-07-04', '2015-07-05', '2015-07-06',
#                '2015-07-07', '2015-07-08', '2015-07-09', '2015-07-10'],
#               dtype='datetime64[ns]', freq='D')
此外,日期范围不一定非是开始时间与结束时间,也可以是开始时间与周期数periods。
print(pd.date_range("2015-07-03", periods=5))
# DatetimeIndex(['2015-07-03', '2015-07-04', '2015-07-05', '2015-07-06',
#                '2015-07-07'],
#               dtype='datetime64[ns]', freq='D')
可以通过freq参数设置时间频率,默认值是D。此处改为h,按小时变化的时间戳。
print(pd.date_range("2015-07-03", periods=5, freq="h"))
# DatetimeIndex(['2015-07-03 00:00:00', '2015-07-03 01:00:00',
#                '2015-07-03 02:00:00', '2015-07-03 03:00:00',
#                '2015-07-03 04:00:00'],
#               dtype='datetime64[ns]', freq='h')
2)时间频率与偏移量 (1)可通过freq参数设置时间频率 下表为常见时间频率代码与说明:
| 代码 | 说明 |
|---|---|
D | 日历天(calendar day),包含周六日 |
B | 工作日(business day),跳过周六日 |
W | 周(weekly),默认周日为一周结束 |
ME / M | 月末(month end),M 旧写法,推荐新写法 ME |
BME | 工作日月末,若月末是周末则取前一个工作日 |
MS | 月初(month start) |
BMS | 工作日月初,若月初是周末则取之后第一个工作日 |
QE / Q | 季末(quarter end),旧写法Q,推荐QE |
BQE | 工作日季末 |
QS | 季初(quarter start) |
BQS | 工作日季初 |
YE / Y | 年末(year end),旧写法Y,推荐YE |
BYE | 工作日年末 |
YS | 年初(year start) |
BYS | 工作日年初 |
h | 小时(hours) |
bh | 工作小时(business hours) |
min | 分钟(minutes) |
s | 秒(seconds) |
ms | 毫秒(milliseconds) |
us | 微秒(microseconds) |
ns | 纳秒(nanoseconds) |
(2)偏移量 可以在频率代码后面加三位月份缩写字母来改变季、年频率的开始时间。
- QE-JAN、BQE-FEB、QS-MAR、BQS-APR等
- YE-JAN、BYE-FEB、YS-MAR、BYS-APR等
pythonprint(pd.date_range("2015-07-03", periods=10, freq="QE-JAN"))  # 设置1月为季度末
# DatetimeIndex(['2015-07-31', '2015-10-31', '2016-01-31', '2016-04-30',
#                '2016-07-31', '2016-10-31', '2017-01-31', '2017-04-30',
#                '2017-07-31', '2017-10-31'],
#               dtype='datetime64[ns]', freq='QE-JAN')
同理,也可以在后面加三位星期缩写字母来改变一周的开始时间。
- W-SUN、W-MON、W-TUE、W-WED等
pythonprint(pd.date_range("2015-07-03", periods=10, freq="W-WED"))  # 设置周三为一周的第一天
# DatetimeIndex(['2015-07-08', '2015-07-15', '2015-07-22', '2015-07-29',
#                '2015-08-05', '2015-08-12', '2015-08-19', '2015-08-26',
#                '2015-09-02', '2015-09-09'],
#               dtype='datetime64[ns]', freq='W-WED')
在这些代码的基础上,还可以将频率组合起来创建的新的周期。例如,可以用小时(h)和分钟(min)的组合来实现2小时30分钟。
pythonprint(pd.date_range("2015-07-03", periods=10, freq="2h30min"))
# DatetimeIndex(['2015-07-03 00:00:00', '2015-07-03 02:30:00',
#                '2015-07-03 05:00:00', '2015-07-03 07:30:00',
#                '2015-07-03 10:00:00', '2015-07-03 12:30:00',
#                '2015-07-03 15:00:00', '2015-07-03 17:30:00',
#                '2015-07-03 20:00:00', '2015-07-03 22:30:00'],
#               dtype='datetime64[ns]', freq='150min')
11.5 重新采样
处理时间序列数据时,经常需要按照新的频率(更高频率、更低频率)对数据进行重新采样。可以通过resample()方法解决这个问题。resample()方法以数据累计为基础,会将数据按指定的时间周期进行分组,之后可以对其使用聚合函数。
pythondf = pd.read_csv("data/weather.csv")
df["date"] = pd.to_datetime(df["date"])
df.set_index("date", inplace=True)
print(df[["temp_max", "temp_min"]].resample("YE").mean())  # 将数据按年分组,并计算每年的平均最高最低温度
#              temp_max  temp_min
# date
# 2012-12-31  15.276776  7.289617
# 2013-12-31  16.058904  8.153973
# 2014-12-31  16.995890  8.662466
# 2015-12-31  17.427945  8.835616
12 Matplotlib可视化
12.1 Matplotlib简介
1)什么是Matplotlib Matplotlib是一个Python绘图库,广泛用于创建各种类型的静态、动态和交互式图表。它是数据科学、机器学习、工程和科学计算领域中常用的绘图工具之一。
- 支持多种图表类型:折线图(Line plots)、散点图(Scatter plots)、柱状图(Bar charts)、直方图(Histograms)、饼图(Pie charts)、热图(Heatmaps)、箱型图(Box plots)、极坐标图(Polar plots)、3D图(3D plots,配合 mpl_toolkits.mplot3d)。
- 高度自定义:允许用户自定义图表的每个部分,包括标题、轴标签、刻度、图例等。 支持多种颜色、字体和线条样式。提供精确的图形渲染控制,如坐标轴范围、图形大小、字体大小等。
- 兼容性:与NumPy、Pandas等库紧密集成,特别适用于绘制基于数据框和数组的数据可视化。可以输出到多种格式(如PNG、PDF、SVG、EPS等)。
- 交互式绘图:在Jupyter Notebook 中,Matplotlib支持交互式绘图,可以动态更新图表。支持图形缩放、平移等交互操作。
- 动态图表:可以生成动画(使用FuncAnimation类),为用户提供动态数据的可视化。 2)不同开发环境下显示图形
- 在一个脚本文件中使用Matplotlib,那么显示图形的时候必须使用plt.show()。
- 在Notebook中使用Matplotlib,运行命令之后在每一个Notebook的单元中就会直接将PNG格式图形文件嵌入在单元中。
12.2 两种画图接口
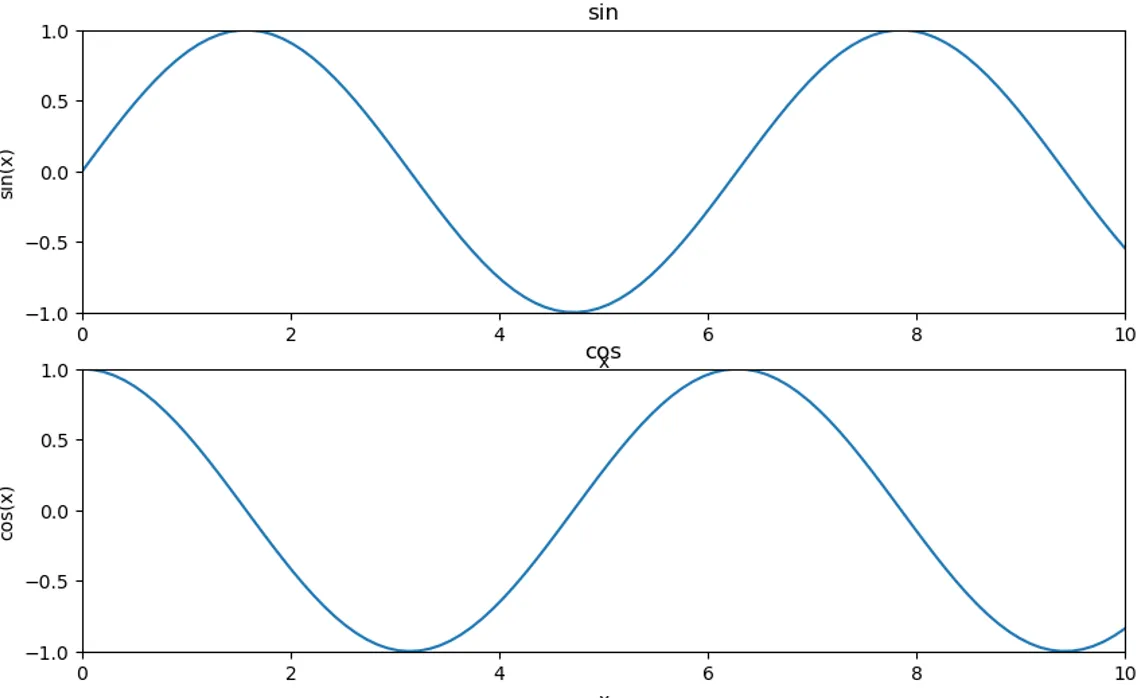
Matplotlib有两种画图接口:一个是便捷的MATLAB风格的有状态的接口,另一个是功能更强大的面向对象接口。 1)状态接口
pythonimport numpy as np
import matplotlib.pyplot as plt  # 导入matplotlib

x = np.linspace(0, 10, 100)  # 创建x轴的数据
y1 = np.sin(x)  # 创建y轴的数据
y2 = np.cos(x)  # 创建y轴的数据

plt.figure(figsize=(10, 6))  # 创建画布,并指定画布大小 10*6英寸

plt.subplot(2, 1, 1)  # 创建2行1列个子图,并指定第1个子图
plt.xlim(0, 10)  # 设置x轴的范围
plt.ylim(-1, 1)  # 设置y轴的范围
plt.xlabel("x")  # 设置x轴的标签
plt.ylabel("sin(x)")  # 设置y轴的标签
plt.title("sin")  # 设置子图的标题
plt.plot(x, y1)  # 绘制曲线

plt.subplot(2, 1, 2)  # 创建2行1列个子图,并指定第2个子图
plt.xlim(0, 10)  # 设置x轴的范围
plt.ylim(-1, 1)  # 设置y轴的范围
plt.xlabel("x")  # 设置x轴的标签
plt.ylabel("cos(x)")  # 设置y轴的标签
plt.title("cos")  # 设置子图的标题
plt.plot(x, y2)

plt.show()  # 显示图像
 2)面向对象接口
pythonimport numpy as np
import matplotlib.pyplot as plt  # 导入matplotlib

x = np.linspace(0, 10, 100)  # 创建x轴的数据
y1 = np.sin(x)  # 创建y轴的数据
y2 = np.cos(x)  # 创建y轴的数据

fig, ax = plt.subplots(2, figsize=(10, 6))  # 创建画布,并指定画布大小

ax[0].set_xlim(0, 10)  # 设置x轴的范围
ax[0].set_ylim(-1, 1)  # 设置y轴的范围
ax[0].set_xlabel("x")  # 设置x轴的标签
ax[0].set_ylabel("sin(x)")  # 设置y轴的标签
ax[0].set_title("sin")  # 设置子图的标题
ax[0].plot(x, y1)  # 绘制曲线

ax[1].plot(x, y2)  # 绘制曲线
ax[1].set_xlim(0, 10)  # 设置x轴的范围
ax[1].set_ylim(-1, 1)  # 设置y轴的范围
ax[1].set_xlabel("x")  # 设置x轴的标签
ax[1].set_ylabel("cos(x)")  # 设置y轴的标签
ax[1].set_title("cos")  # 设置子图的标题

plt.show()
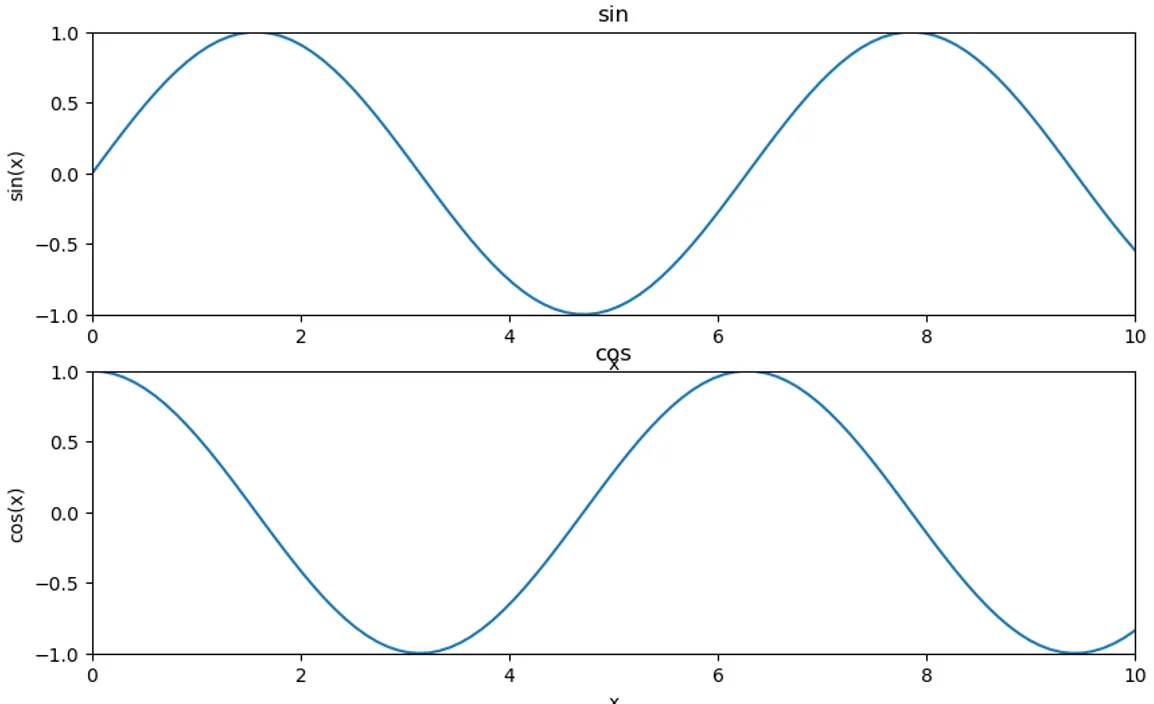
12.3 单变量可视化
使用weather(天气)数据集。其中包含6个字段:
- date:日期,年-月-日格式。
- precipitation:降水量。
- temp_max:最高温度。
- temp_min:最低温度。
- wind:风力。
- weather:天气状况。 加载数据:
pythonimport pandas as pd
import matplotlib.pyplot as plt
from matplotlib import rcParams

rcParams["font.sans-serif"] = ["SimHei"]  # 指定中文字体
rcParams["axes.unicode_minus"] = False  # 解决负号显示问题

df = pd.read_csv("data/weather.csv")
df.info()  # 查看数据集信息
# RangeIndex: 1461 entries, 0 to 1460
# Data columns (total 6 columns):
#  #   Column         Non-Null Count  Dtype
# ---  ------         --------------  -----
#  0   date           1461 non-null   object
#  1   precipitation  1461 non-null   float64
#  2   temp_max       1461 non-null   float64
#  3   temp_min       1461 non-null   float64
#  4   wind           1461 non-null   float64
#  5   weather        1461 non-null   object
# dtypes: float64(4), object(2)
# memory usage: 68.6+ KB
使用直方图将降水量分组并绘制每组出现频次。
pythonfig = plt.figure()
ax1 = fig.add_subplot(1, 1, 1)
ax1.hist(df["precipitation"], bins=5)  # 绘制直方图,将降水量均匀分为5组
ax1.set_xlabel("降水量")
ax1.set_ylabel("出现频次")
plt.show()
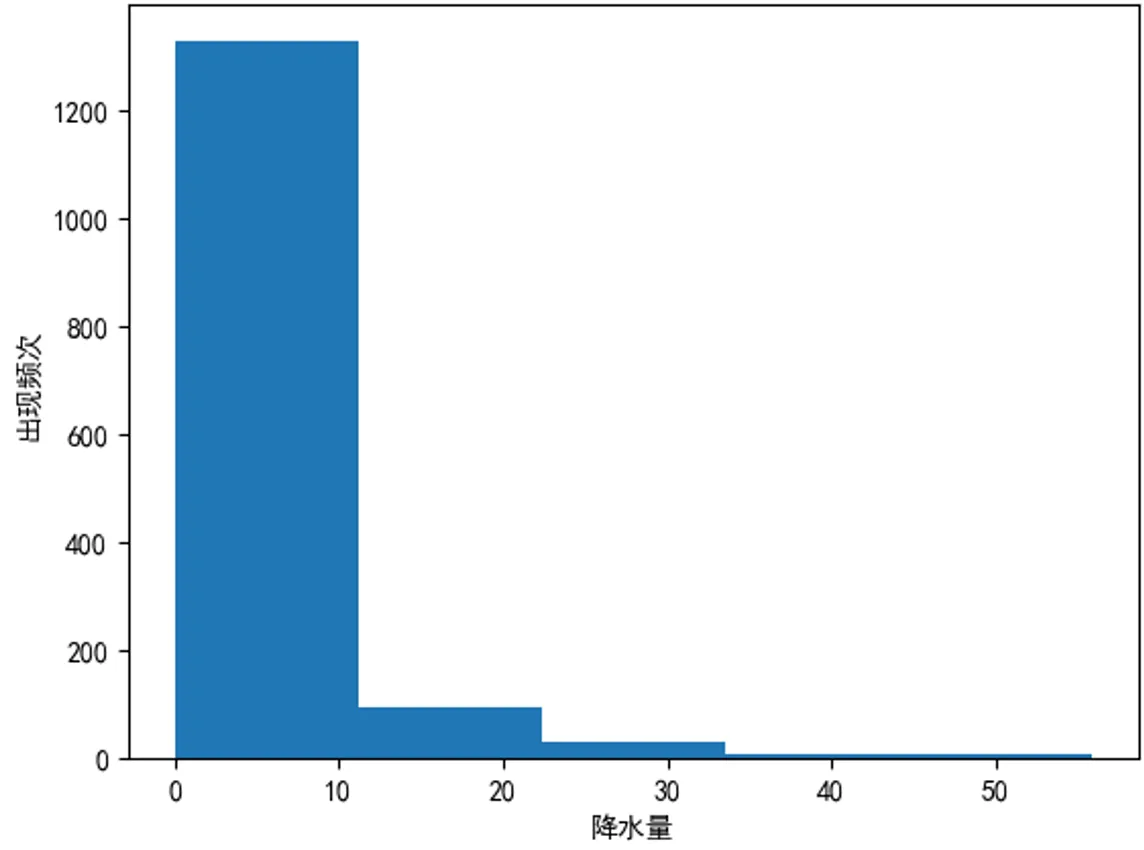
12.4 多变量可视化
1)双变量 使用散点图呈现降水量随最高气温变化的大致趋势。
pythonimport pandas as pd
import matplotlib.pyplot as plt
from matplotlib import rcParams

rcParams["font.sans-serif"] = ["SimHei"]  # 指定中文字体
rcParams["axes.unicode_minus"] = False  # 解决负号显示问题

df = pd.read_csv("data/weather.csv")
fig = plt.figure()
ax1 = fig.add_subplot(1, 1, 1)
ax1.scatter(df["temp_max"], df["precipitation"])  # 绘制散点图,横轴为最高气温,纵轴为降水量
ax1.set_xlabel("最高气温")
ax1.set_ylabel("降水量")
plt.show()
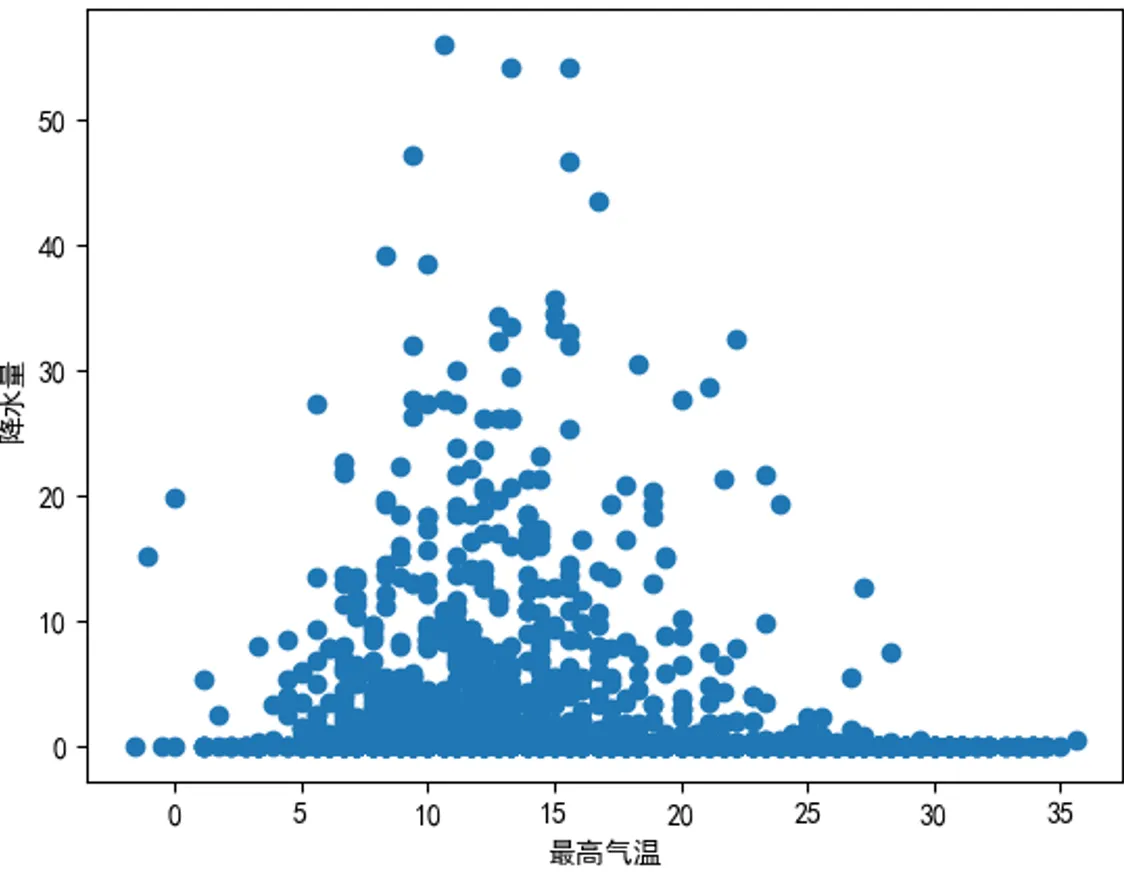
2)多变量 使用散点图呈现降水量随最高气温变化的大致趋势,用不同颜色区分不同年份的数据。
pythonimport pandas as pd
import matplotlib.pyplot as plt
from matplotlib import rcParams

rcParams["font.sans-serif"] = ["SimHei"]  # 指定中文字体
rcParams["axes.unicode_minus"] = False  # 解决负号显示问题

def year_color(x):
    """添加一列,为不同年份的数据添加不同的颜色"""
    match x.year:
        case 2012:
            return "r"
        case 2013:
            return "g"
        case 2014:
            return "b"
        case 2015:
            return "k"

df = pd.read_csv("data/weather.csv")
df["date"] = pd.to_datetime(df["date"])
df["color"] = df["date"].apply(year_color)
fig = plt.figure()
ax1 = fig.add_subplot(1, 1, 1)
# 绘制散点图,横轴为最高气温,纵轴为降水量
# c设置颜色,alpha设置透明度
ax1.scatter(df["temp_max"], df["precipitation"], c=df["color"], alpha=0.5)
ax1.set_xlabel("最高气温")
ax1.set_ylabel("降水量")
plt.show()
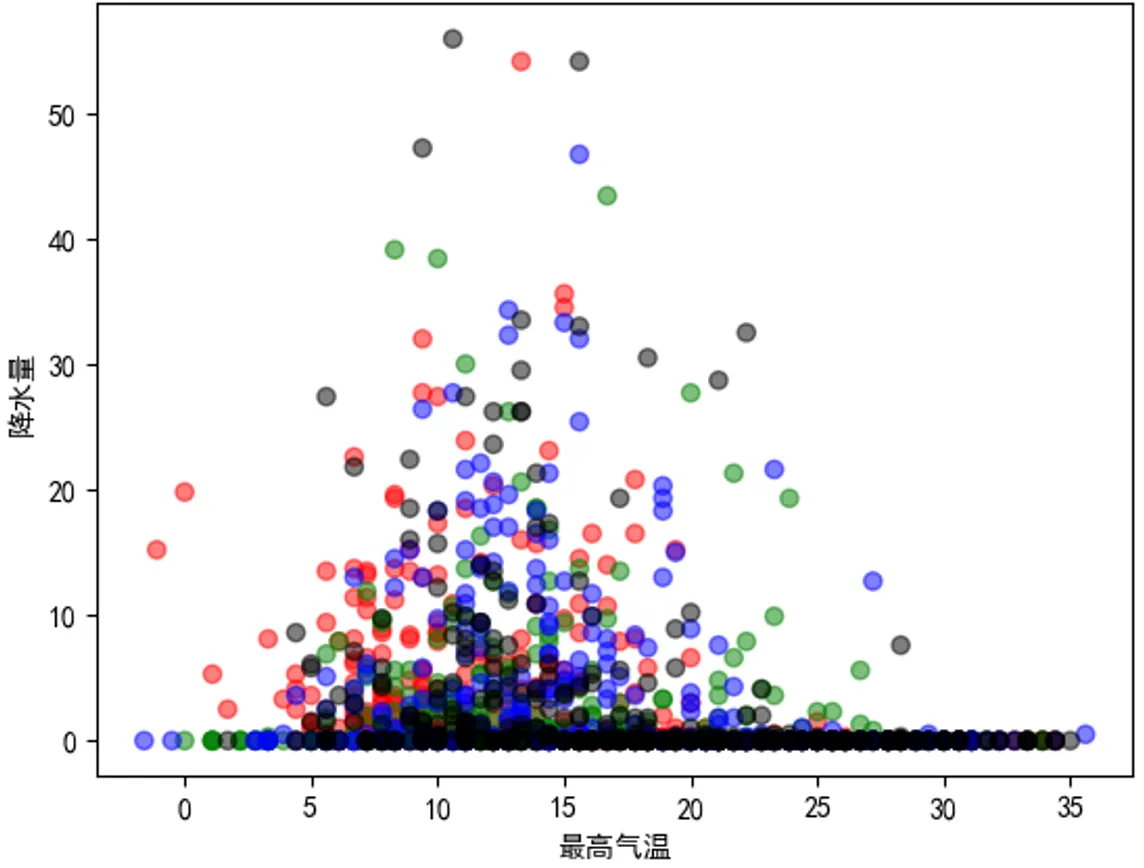
13. Pandas可视化
pandas提供了非常方便的绘图功能,可以直接在DataFrame或Series上调用plot()方法来生成各种类型的图表。底层实现依赖于Matplotlib,pandas的绘图功能集成了许多常见的图形类型,易于使用。
13.1 单变量可视化
使用sleep(睡眠健康和生活方式)数据集,其中包含13个字段:
- person_id:每个人的唯一标识符。
- gender:个人的性别(男/女)。
- age:个人的年龄(以岁为单位)。
- occupation:个人的职业或就业状况(例如办公室职员、体力劳动者、学生)。
- sleep_duration:每天的睡眠总小时数。
- sleep_quality:睡眠质量的主观评分,范围从 1(差)到 10(极好)。
- physical_activity_level:每天花费在体力活动上的时间(以分钟为单位)。
- stress_level:压力水平的主观评级,范围从 1(低)到 10(高)。
- bmi_category:个人的 BMI 分类(体重过轻、正常、超重、肥胖)。
- blood_pressure:血压测量,显示为收缩压与舒张压的数值。
- heart_rate:静息心率,以每分钟心跳次数为单位。
- daily_steps:个人每天行走的步数。
- sleep_disorder:存在睡眠障碍(无、失眠、睡眠呼吸暂停)。 加载数据:
pythonimport pandas as pd

df = pd.read_csv("data/sleep.csv")
df.info()  # 查看数据集信息
# RangeIndex: 400 entries, 0 to 399
# Data columns (total 13 columns):
#  #   Column                   Non-Null Count  Dtype
# ---  ------                   --------------  -----
#  0   person_id                400 non-null    int64
#  1   gender                   400 non-null    object
#  2   age                      400 non-null    int64
#  3   occupation               400 non-null    object
#  4   sleep_duration           400 non-null    float64
#  5   sleep_quality            400 non-null    float64
#  6   physical_activity_level  400 non-null    int64
#  7   stress_level             400 non-null    int64
#  8   bmi_category             400 non-null    object
#  9   blood_pressure           400 non-null    object
#  10  heart_rate               400 non-null    int64
#  11  daily_steps              400 non-null    int64
#  12  sleep_disorder           110 non-null    object
# dtypes: float64(2), int64(6), object(5)
# memory usage: 40.8+ KB
1)柱状图 柱状图用于展示类别数据的分布情况。它通过一系列矩形的高度(或长度)来展示数据值,适合对比不同类别之间的数量或频率。简单直观,容易理解和比较各类别数据。 使用柱状图展示不同睡眠时长的数量。
pd.cut(df["sleep_duration"], [0, 5, 6, 7, 8, 9, 10, 11, 12]).value_counts().plot.bar(
    color=["red", "green", "blue", "yellow", "cyan", "magenta", "black", "purple"]
)
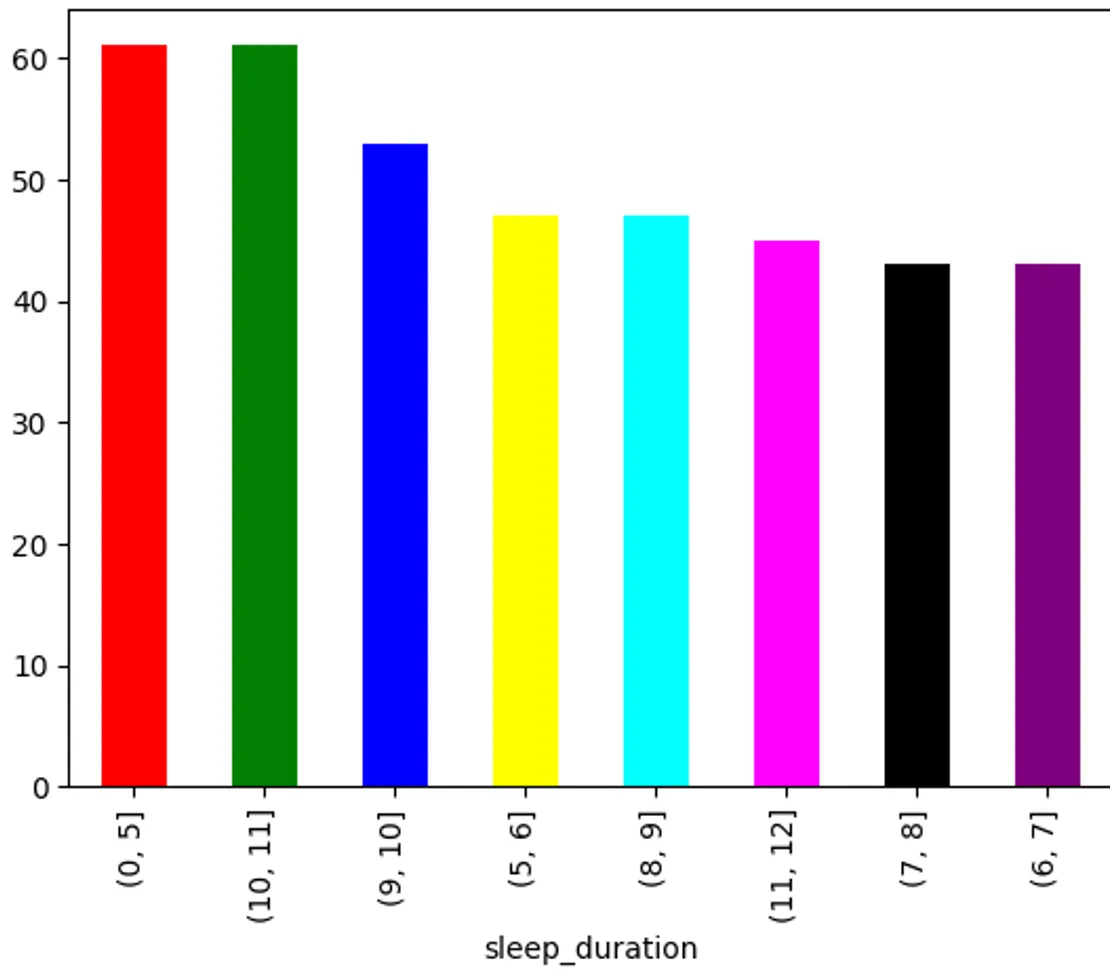 2)折线图
折线图通常用于展示连续数据的变化趋势。它通过一系列数据点连接成的线段来表示数据的变化。能够清晰地展示数据的趋势和波动。
使用折线图展示不同睡眠时长的数量。
pd.cut(df["sleep_duration"], [0, 5, 6, 7, 8, 9, 10, 11, 12]).value_counts().sort_index().plot()
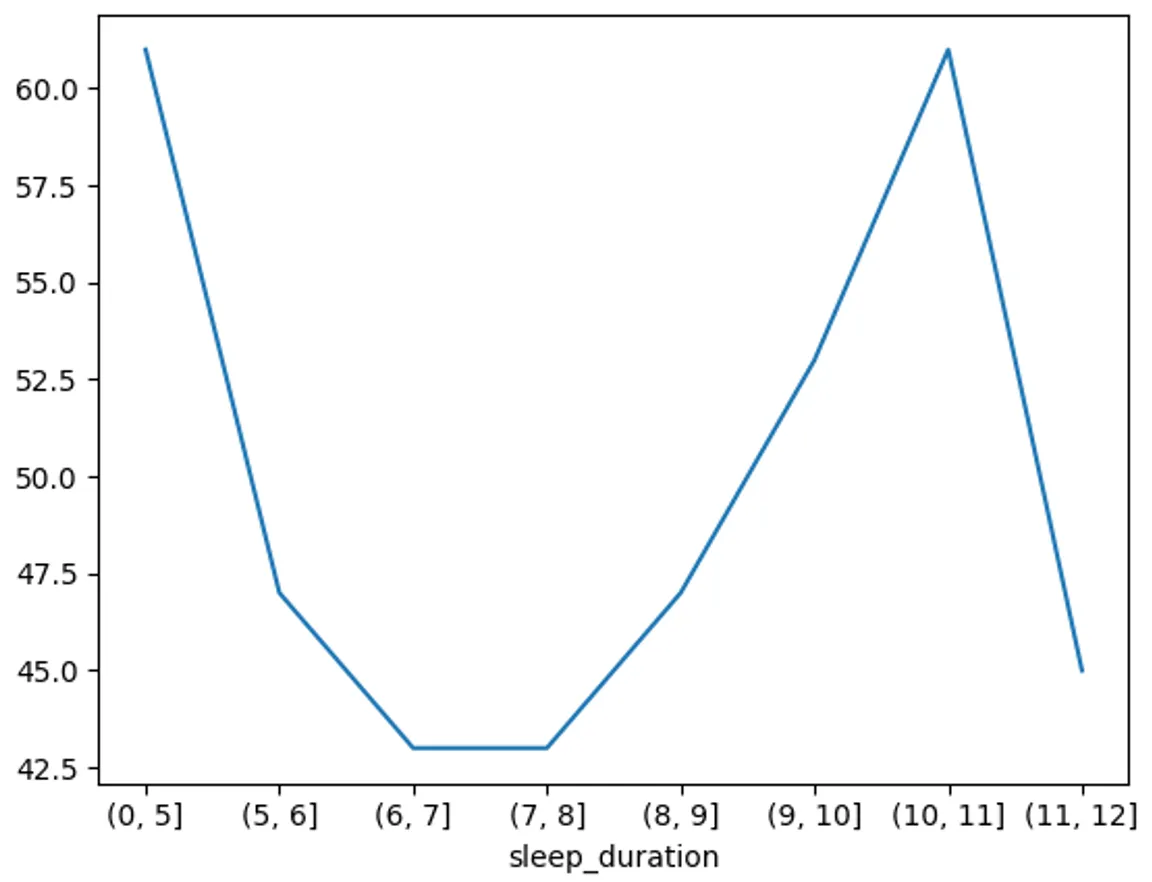
3)面积图 面积图是折线图的一种变体,线下的区域被填充颜色,用于强调数据的总量或变化。可以更直观地展示数据量的变化,适合用来展示多个分类的累计趋势。 使用面积图展示不同睡眠时长的数量。
pd.cut(df["sleep_duration"], [0, 5, 6, 7, 8, 9, 10, 11, 12]).value_counts().sort_index().plot.area()
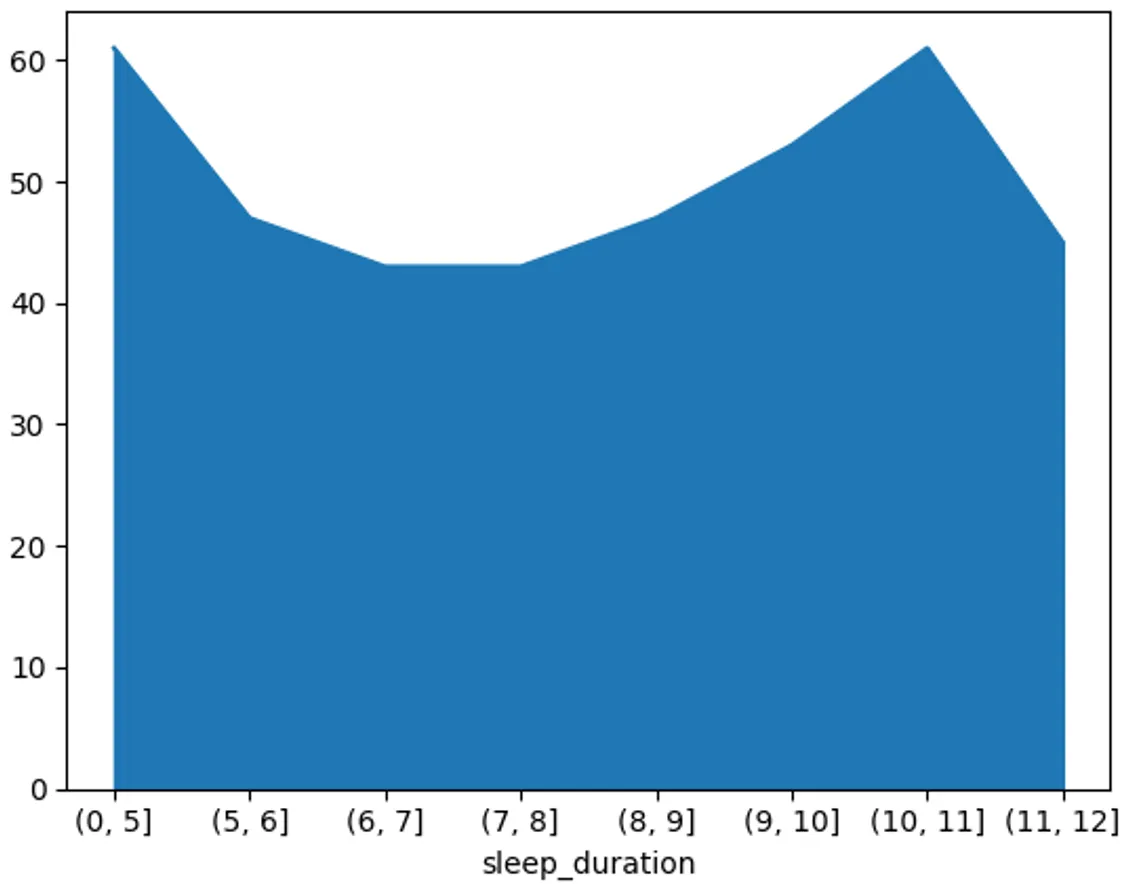
4)直方图 直方图用于展示数据的分布情况。它将数据范围分成多个区间,并通过矩形的高度显示每个区间内数据的频率或数量。可以揭示数据分布的模式,如偏态、峰度等。 使用直方图展示不同睡眠时长的数量。
df["sleep_duration"].value_counts().plot.hist()
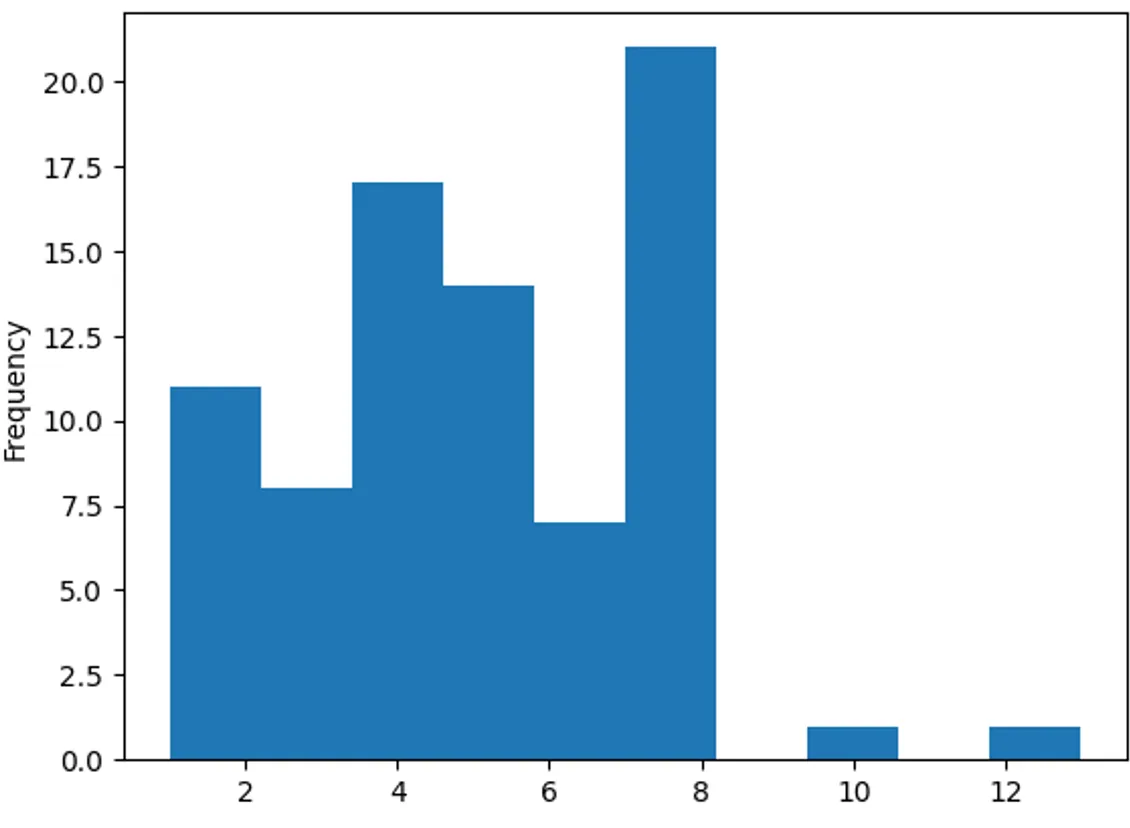
5)饼状图 饼状图用于展示一个整体中各个部分所占的比例。它通过一个圆形图形分割成不同的扇形,每个扇形的角度与各部分的比例成正比。能够快速展示各部分之间的比例关系,但不适合用于展示过多的类别或比较数值差异较小的部分。 使用饼状图展示不同睡眠时长的占比。
pd.cut(df["sleep_duration"], [0, 5, 6, 7, 8, 9, 10, 11, 12]).value_counts().sort_index().plot.pie()
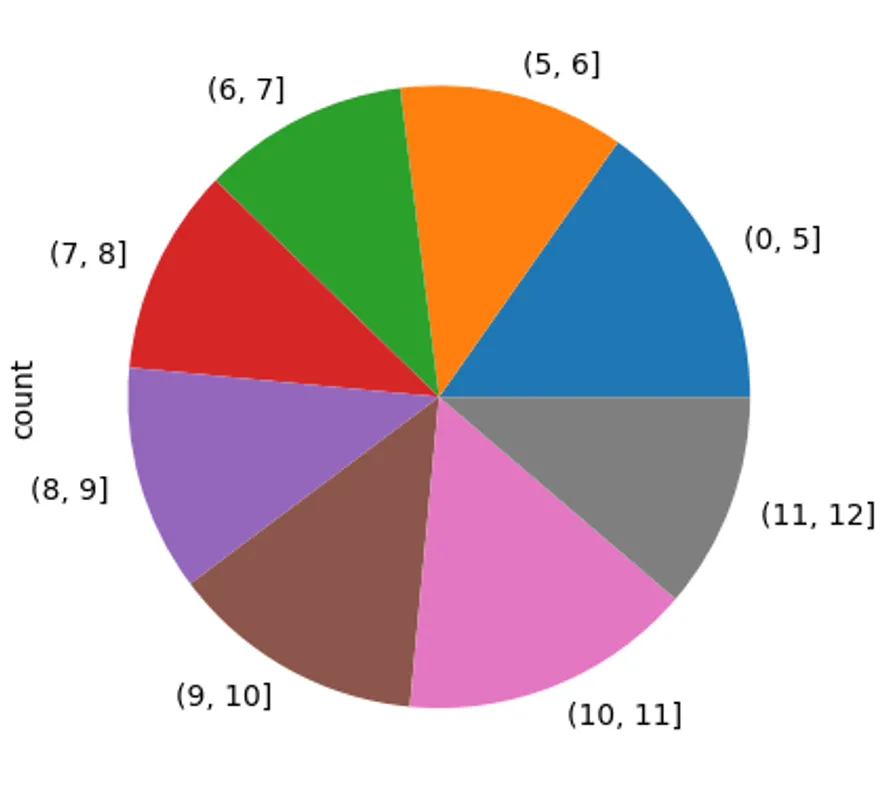
13.2 双变量可视化
1)散点图 散点图通过在二维坐标系中绘制数据点来展示两组数值数据之间的关系。能够揭示两个变量之间的相关性和趋势。 绘制睡眠时间与睡眠质量的散点图。
df.plot.scatter(x="sleep_duration", y="sleep_quality")
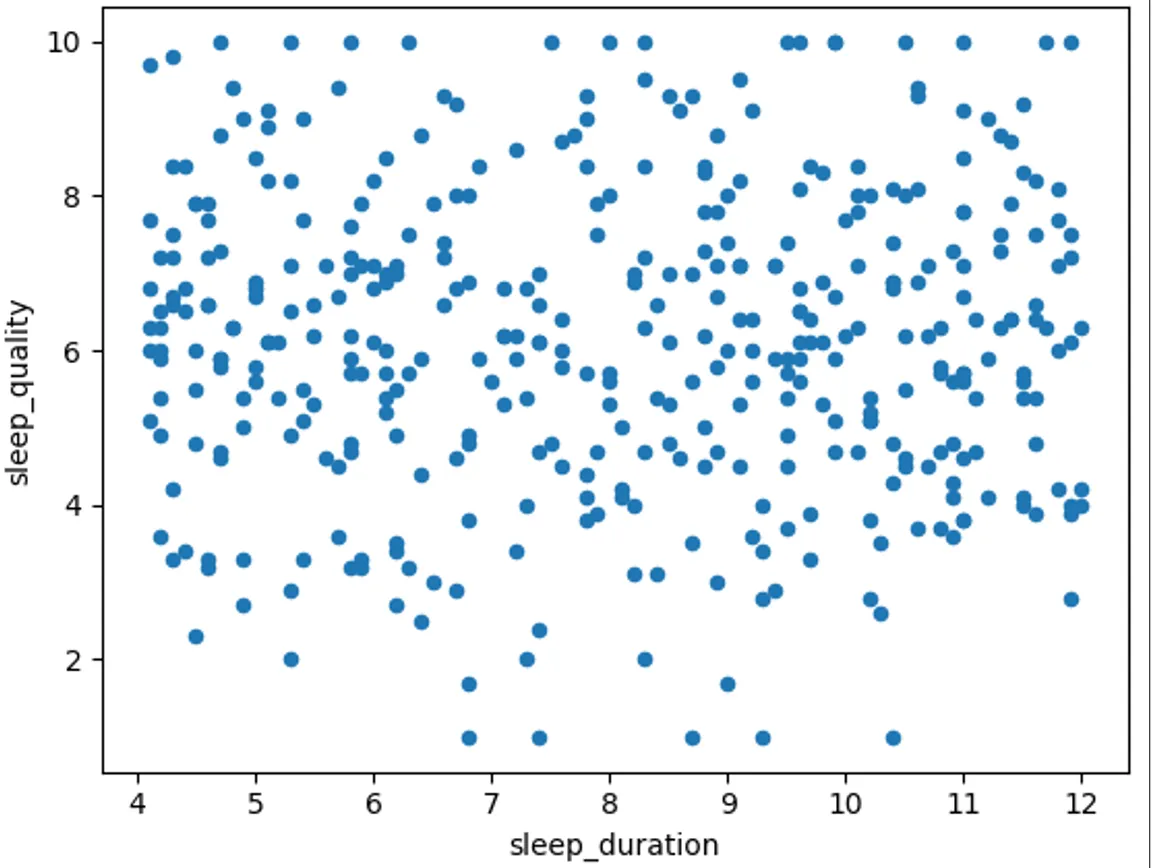
2)蜂窝图 蜂窝图是散点图的扩展,通常用于表示大量数据点之间的关系。它通过将数据点分布在一个六边形网格中,每个六边形的颜色代表其中的数据密度。适合展示大量数据点,避免了散点图中的过度重叠问题。 绘制睡眠时间与睡眠质量的蜂窝图。
df.plot.hexbin(x="sleep_duration", y="sleep_quality", gridsize=10)
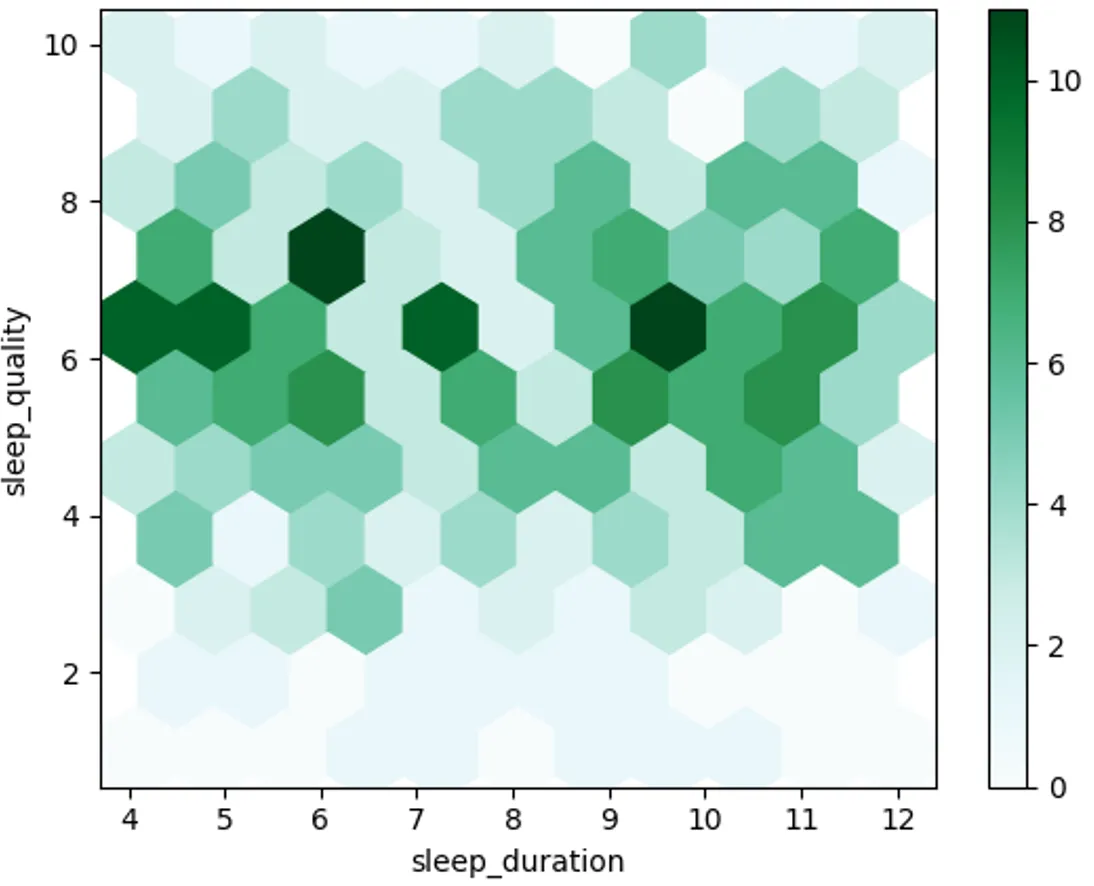
3)堆叠图 堆叠图用于展示多个数据系列的累积变化。常见的堆叠图包括堆叠柱状图、堆叠面积图等。它通过将每个数据系列堆叠在前一个系列之上,展示数据的累积情况。能够清晰地展示不同部分的相对贡献,适合多个数据系列的比较。 绘制睡眠时间与睡眠质量的堆叠图。
pythondf["sleep_quality_stage"] = pd.cut(df["sleep_quality"], range(11))
df["sleep_duration_stage"] = pd.cut(df["sleep_duration"], [0, 5, 6, 7, 8, 9, 10, 11, 12])
df_pivot_table = df.pivot_table(
    values="person_id", index="sleep_quality_stage", columns="sleep_duration_stage", aggfunc="count"
)
df_pivot_table.plot.bar()
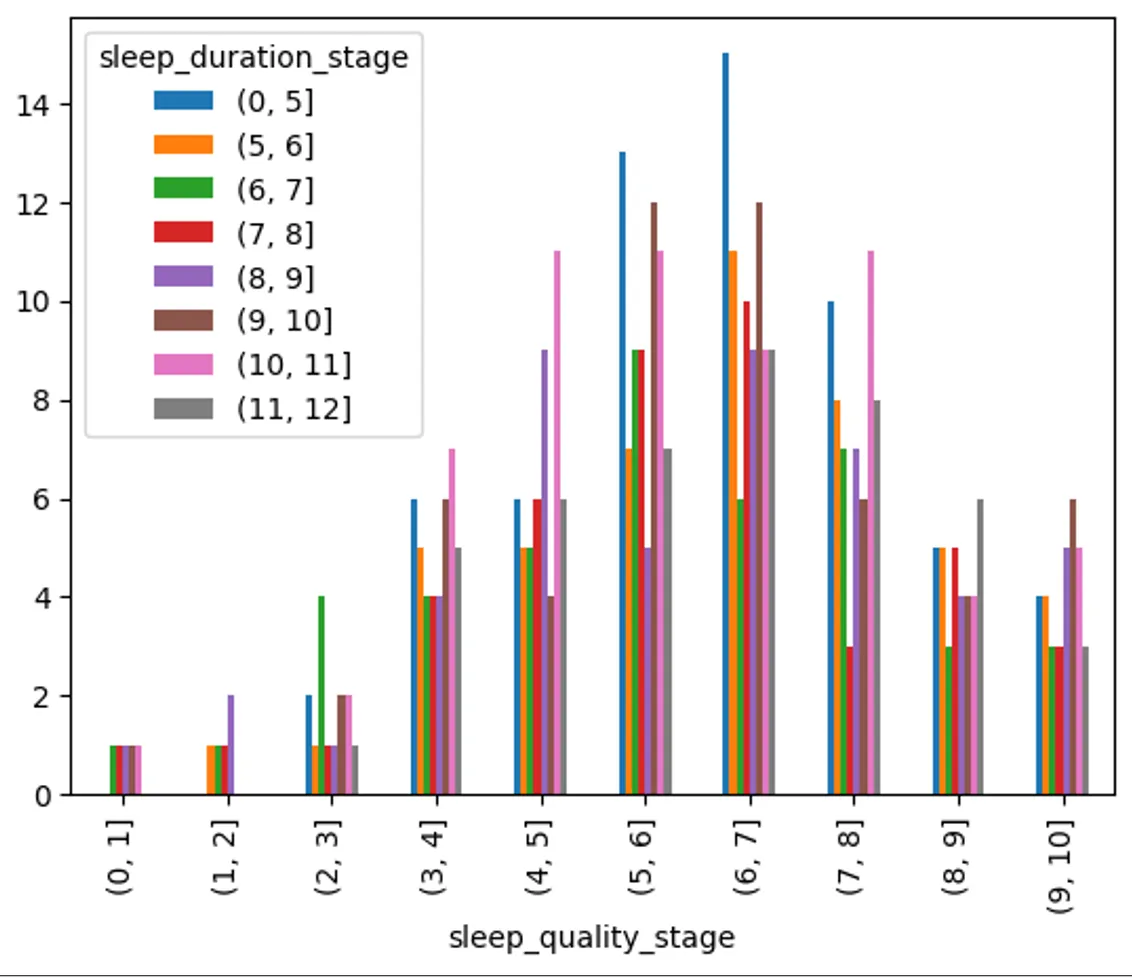
设置stacked=True,会将柱体堆叠。
df_pivot_table.plot.bar(stacked=True)
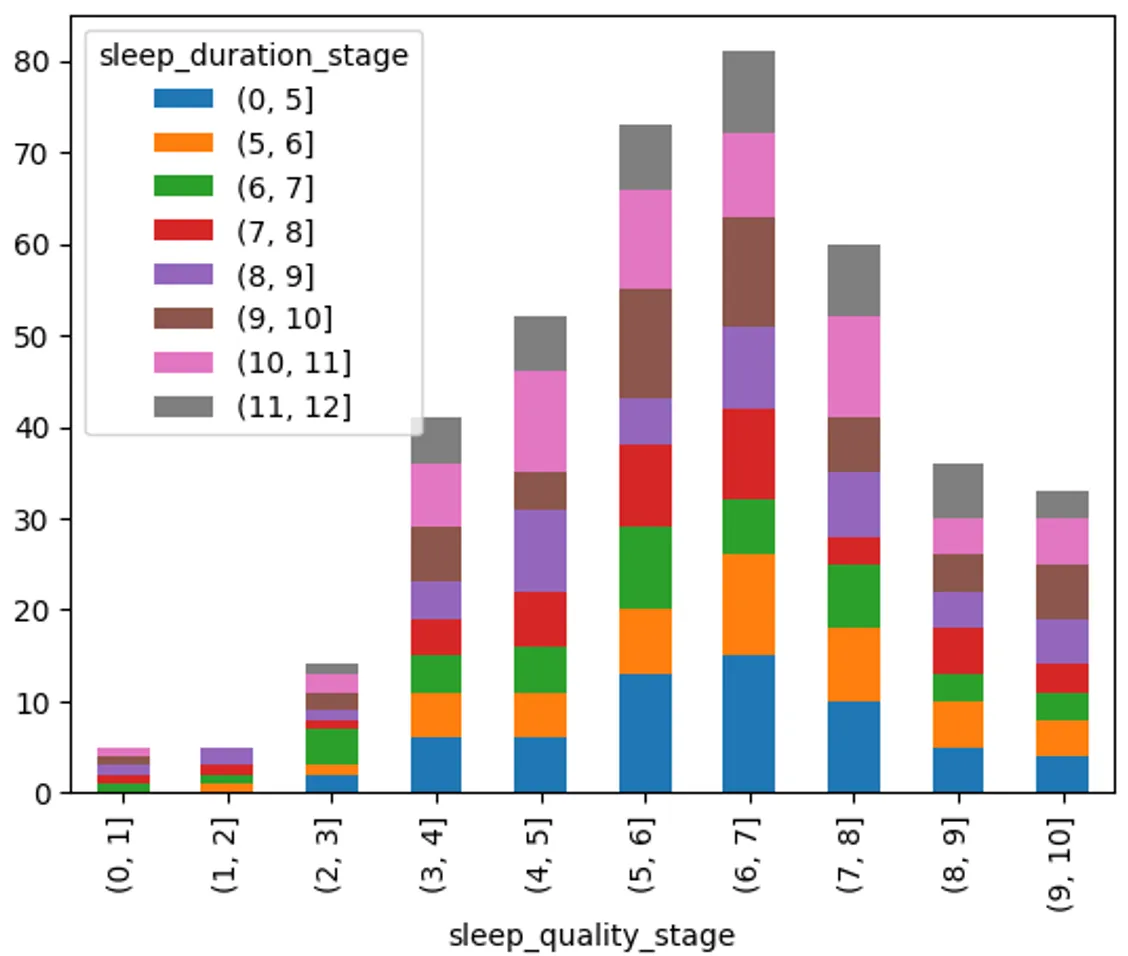
4)折线图
df_pivot_table.plot.line()
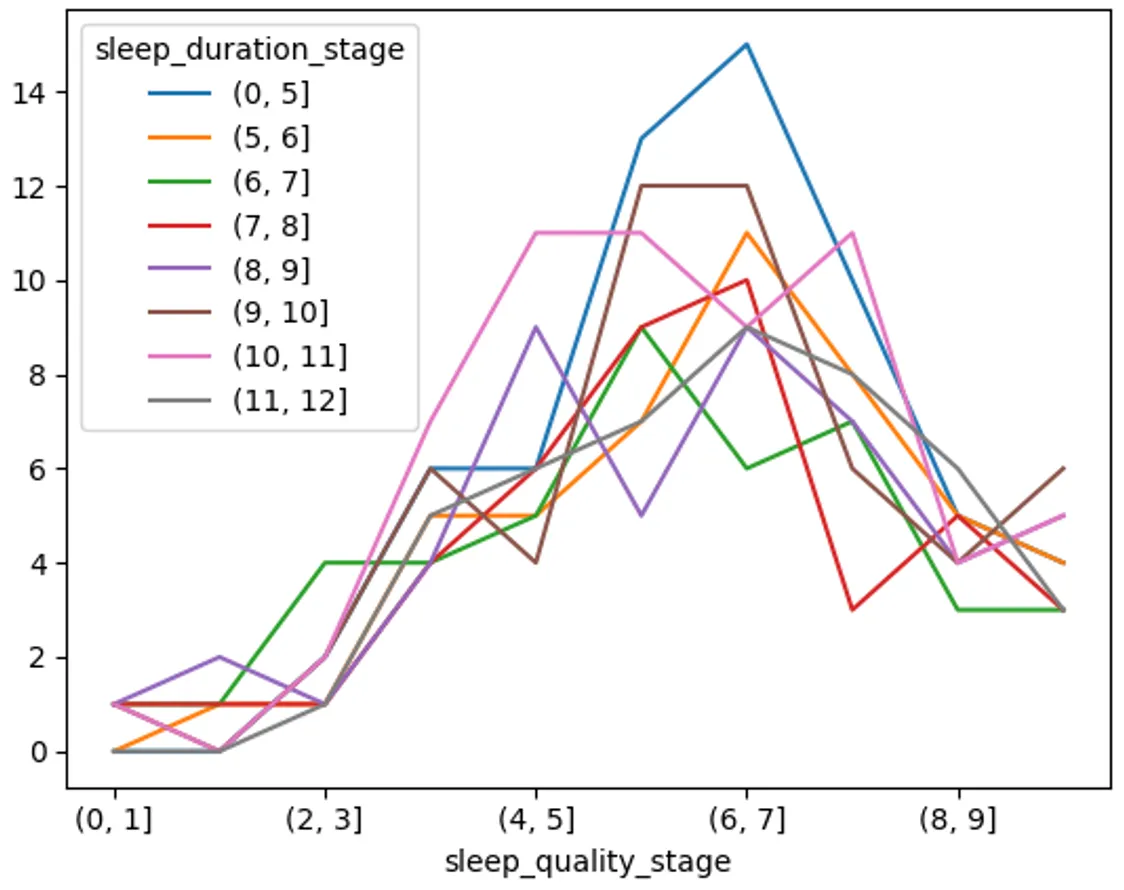
14 Seaborn可视化
14.1 什么是Seaborn
Seaborn是一个基于Matplotlib的Python可视化库,旨在简化数据可视化的过程。它提供了更高级的接口,用于生成漂亮和复杂的统计图表,同时也能保持与Pandas数据结构的良好兼容性。
14.2 单变量可视化
使用penguins(企鹅🐧)数据集,其中包含7个字段:
- species:企鹅种类(Adelie、Gentoo、Chinstrap)。
- island:观测岛屿(Torgersen, Biscoe, Dream)。
- bill_length_mm:喙(嘴)长度(毫米)。
- bill_depth_mm:喙深度(毫米)。
- flipper_length_mm:脚蹼长度(毫米)。
- body_mass_g:体重(克)。
- sex:性别(Male、Female)。
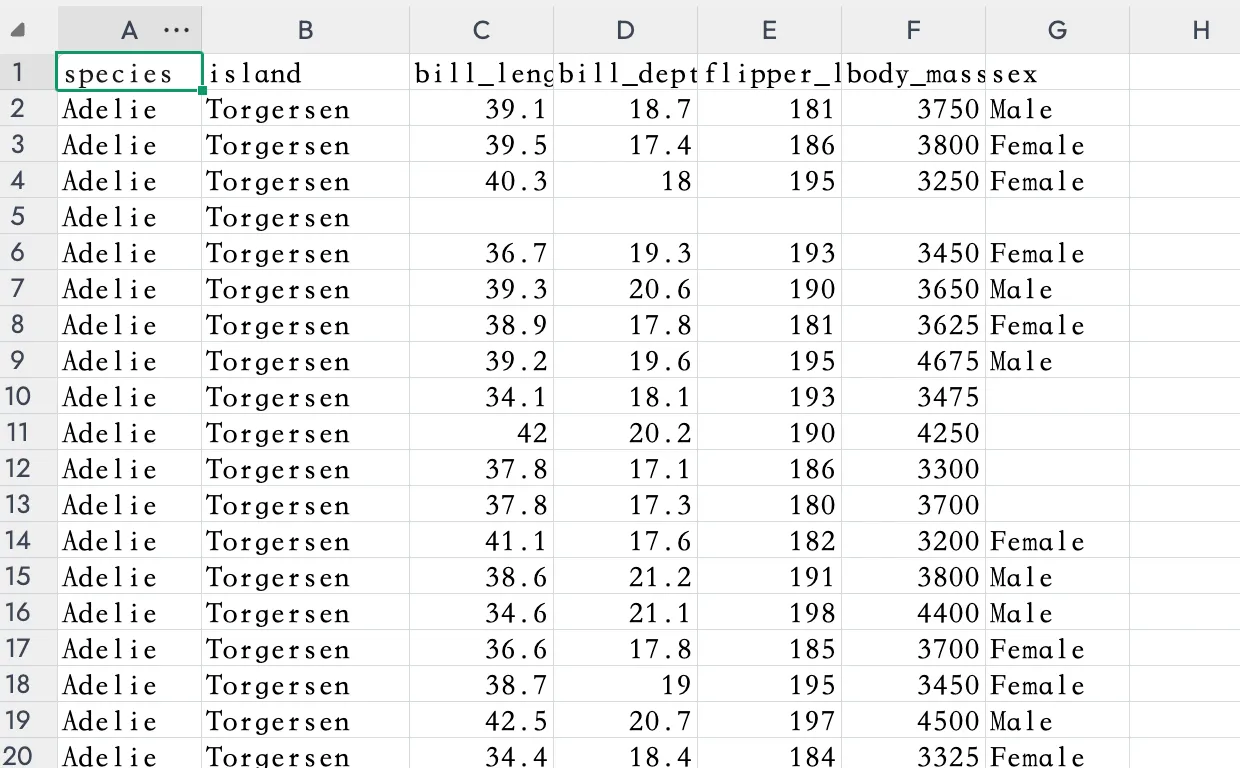 加载数据:
pythonimport pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

plt.rcParams["font.sans-serif"] = ["KaiTi"]
penguins = pd.read_csv("data/penguins.csv")
penguins.dropna(inplace=True)
penguins.info()
# <class 'pandas.core.frame.DataFrame'>
# Index: 333 entries, 0 to 343
# Data columns (total 7 columns):
#  #   Column             Non-Null Count  Dtype
# ---  ------             --------------  -----
#  0   species            333 non-null    object
#  1   island             333 non-null    object
#  2   bill_length_mm     333 non-null    float64
#  3   bill_depth_mm      333 non-null    float64
#  4   flipper_length_mm  333 non-null    float64
#  5   body_mass_g        333 non-null    float64
#  6   sex                333 non-null    object
# dtypes: float64(4), object(3)
# memory usage: 20.8+ KB
1)直方图 绘制不同种类企鹅数量的直方图。
sns.histplot(data=penguins, x="species")
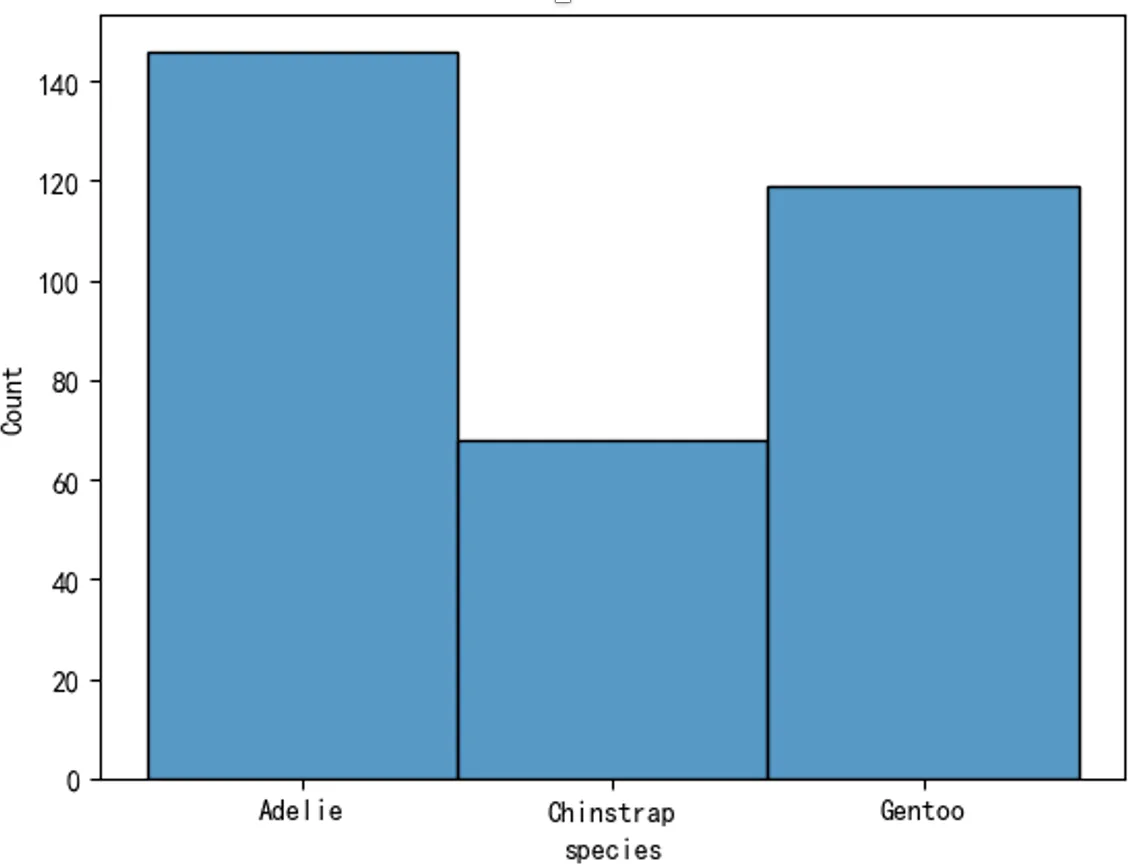
2)核密度估计图 核密度估计图(KDE,Kernel Density Estimate Plot)是一种用于显示数据分布的统计图表,它通过平滑直方图的方法来估计数据的概率密度函数,使得分布图看起来更加连续和平滑。核密度估计是一种非参数方法,用于估计随机变量的概率密度函数。其基本思想是,将每个数据点视为一个“核”(通常是高斯分布),然后将这些核的贡献相加以形成平滑的密度曲线。 绘制喙长度的核密度估计图。
sns.kdeplot(data=penguins, x="bill_length_mm")
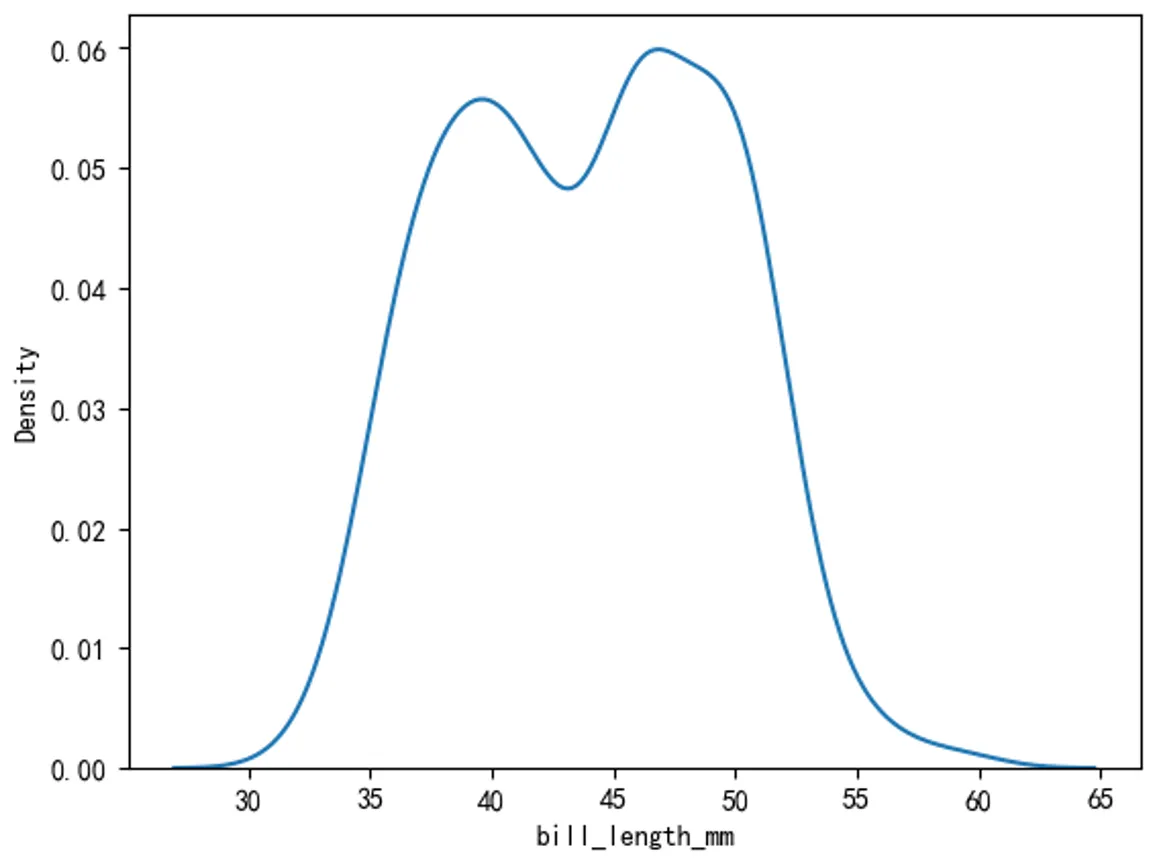
在histplot()中设置kde=True也可以得到核密度估计图。
sns.histplot(data=penguins, x="bill_length_mm", kde=True)
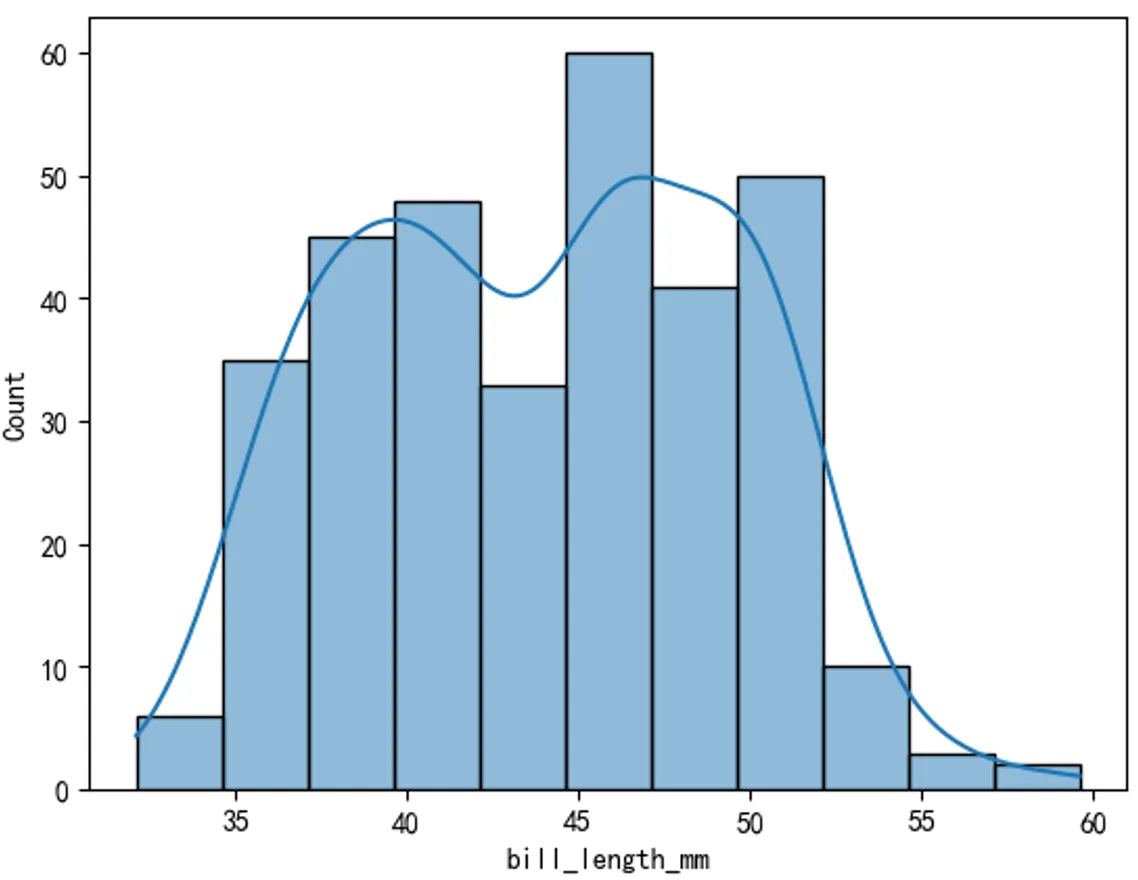
3)计数图 计数图用于绘制分类变量的计数分布图,显示每个类别在数据集中出现的次数,是分析分类数据非常直观的工具,可以快速了解类别的分布情况。 绘制不同岛屿企鹅数量的计数图。
sns.countplot(data=penguins, x="island")
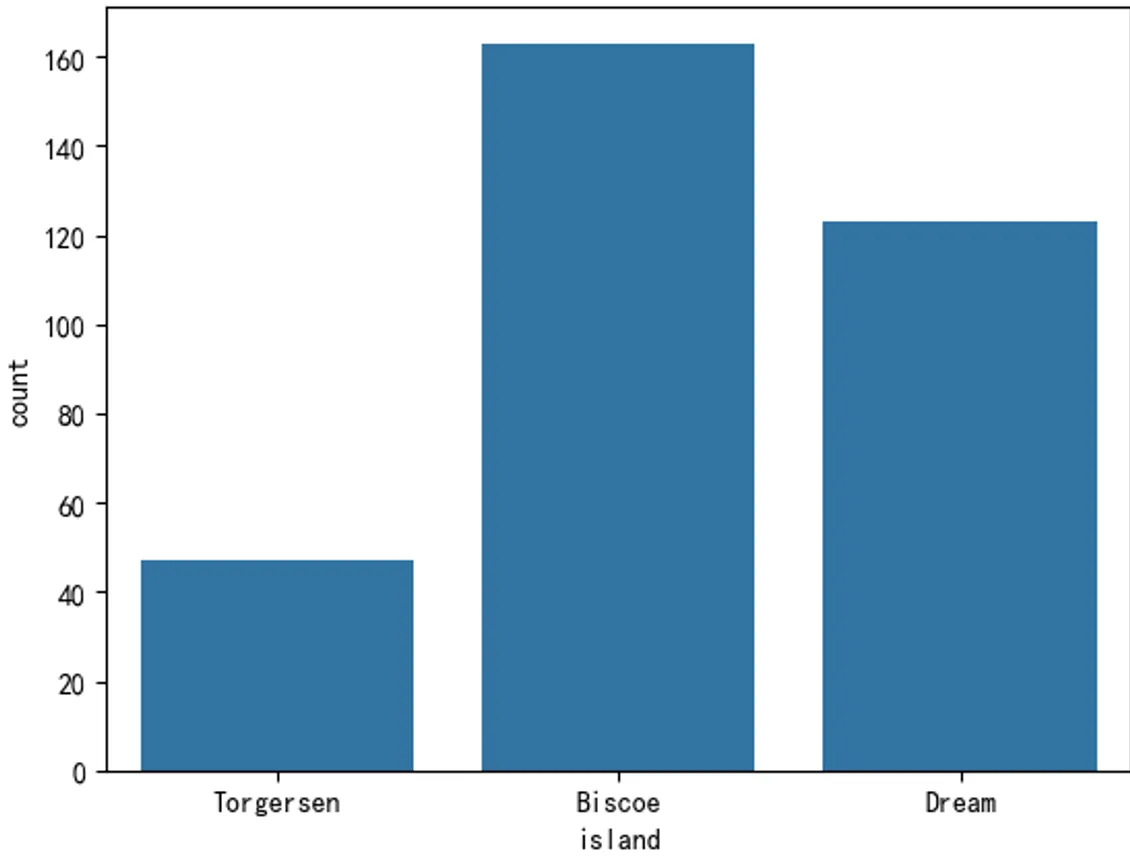
14.3 双变量可视化
1)散点图 绘制横轴为体重,纵轴为脚蹼长度的散点图。可通过hue参数设置不同组别进行对比。
sns.scatterplot(data=penguins, x="body_mass_g", y="flipper_length_mm", hue="sex")
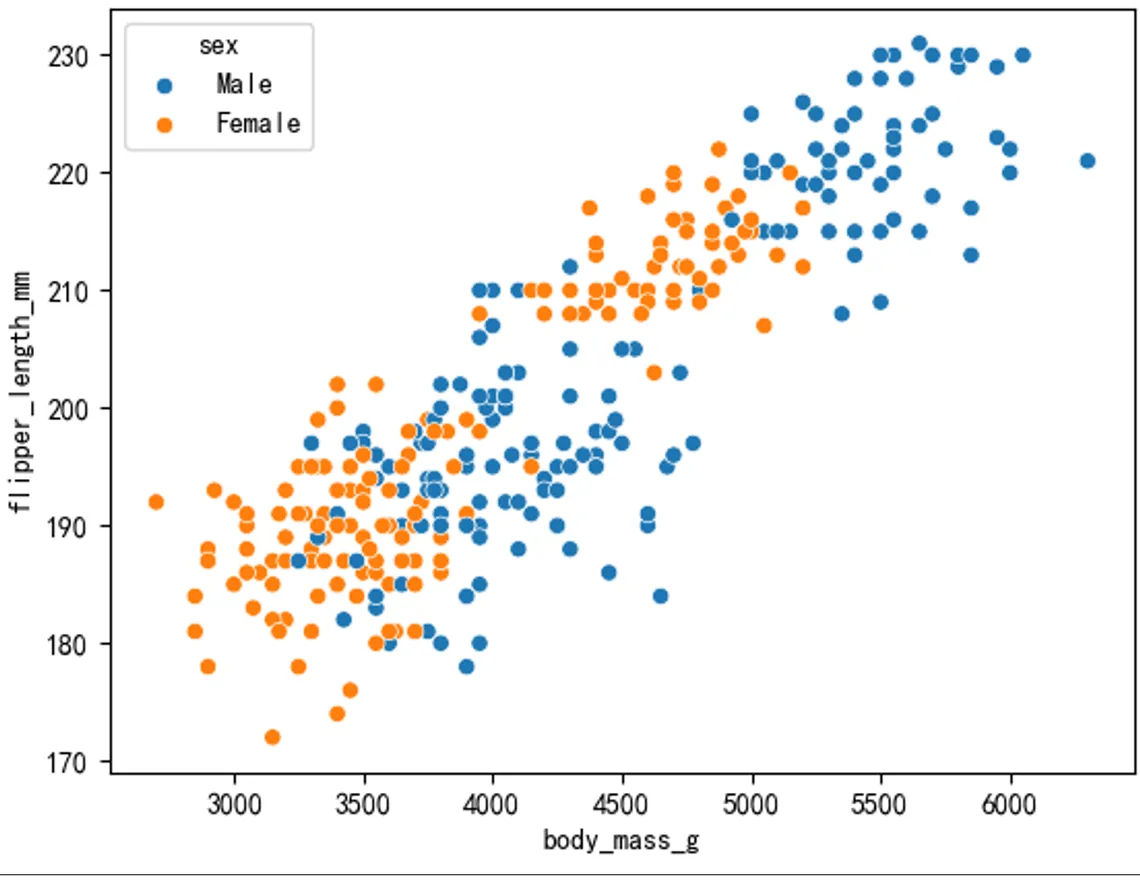
也可以通过regplot()函数绘制散点图,同时会拟合回归曲线。可以通过fit_reg=False关闭拟合。
sns.regplot(data=penguins, x="body_mass_g", y="flipper_length_mm")
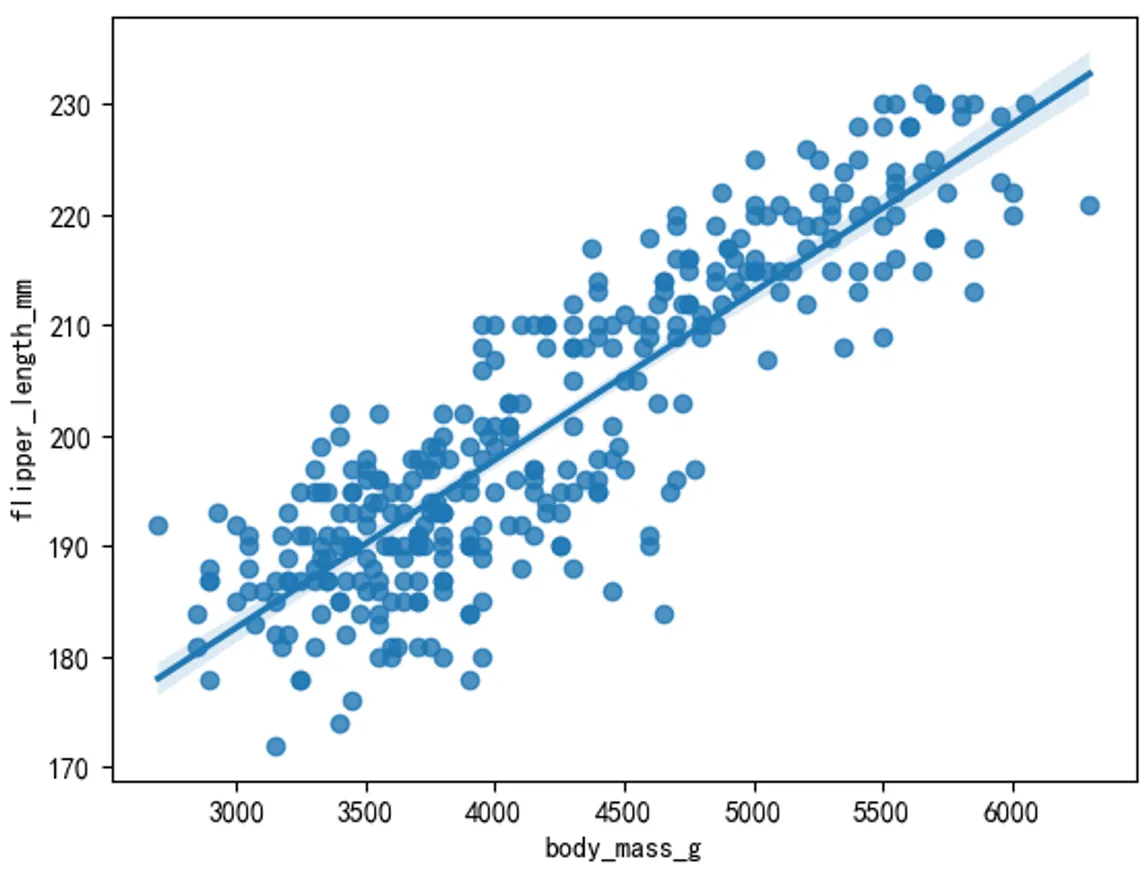
也可以通过lmplot()函数绘制基于hue参数的分组回归图。
sns.lmplot(data=penguins, x="body_mass_g", y="flipper_length_mm", hue="sex")
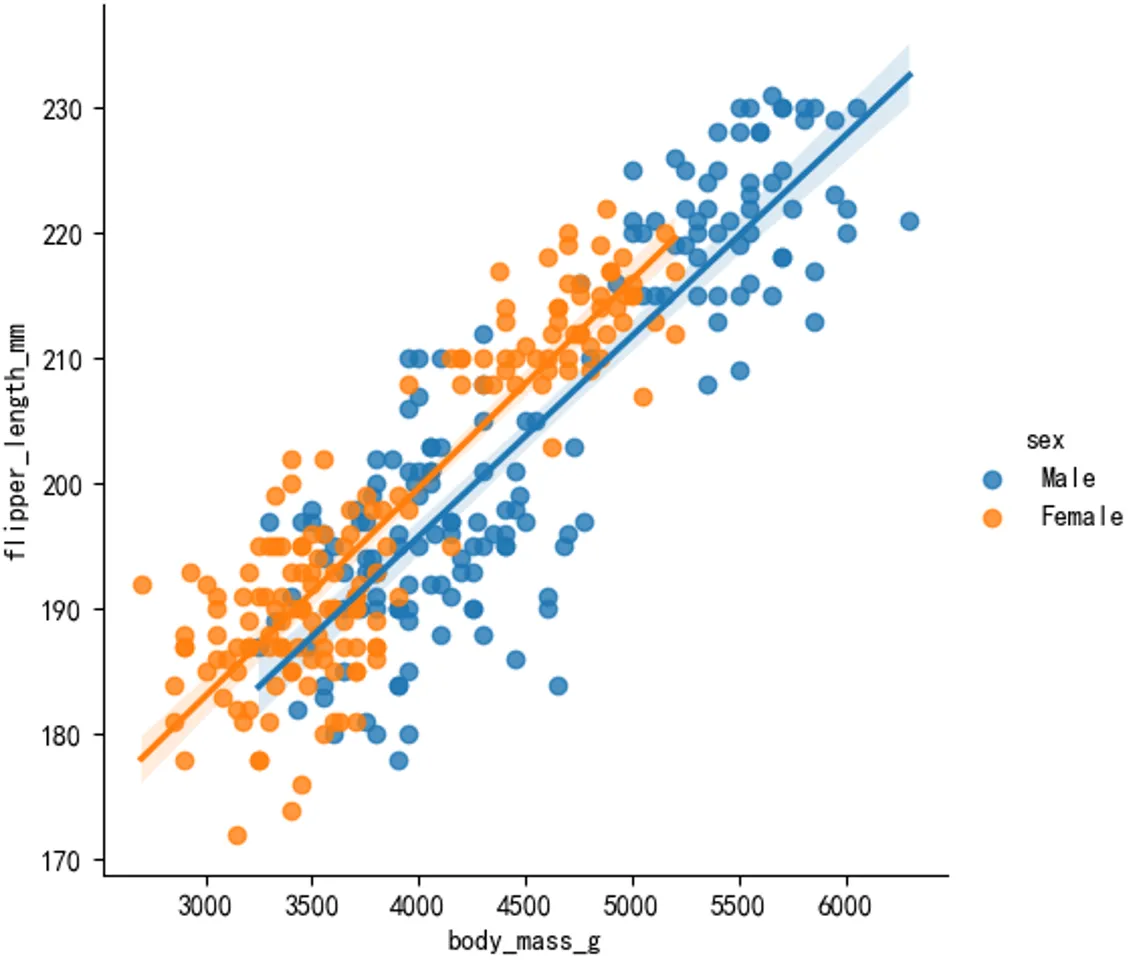
也可以通过jointplot()函数绘制在每个轴上包含单个变量的散点图。
sns.jointplot(data=penguins, x="body_mass_g", y="flipper_length_mm")
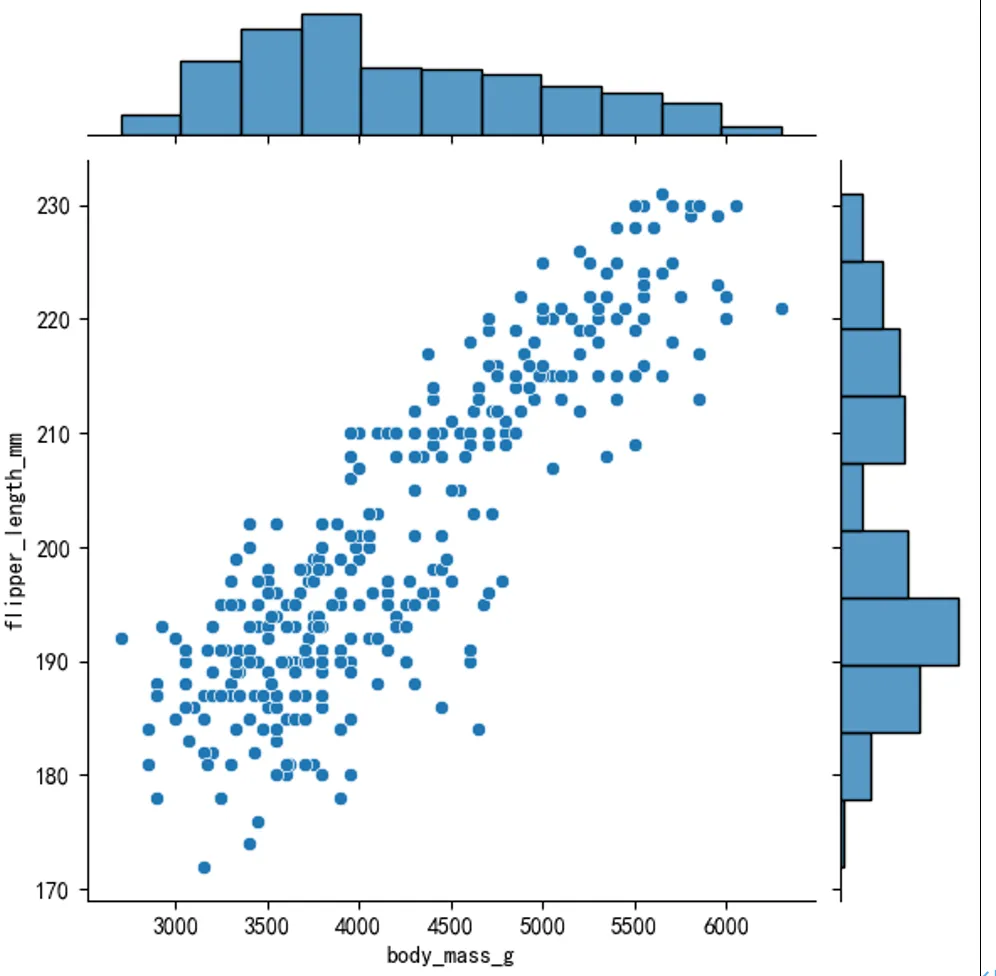
2)蜂窝图 通过jointplot()函数,设置kind="hex"来绘制蜂窝图。
sns.jointplot(data=penguins, x="body_mass_g", y="flipper_length_mm", kind="hex")
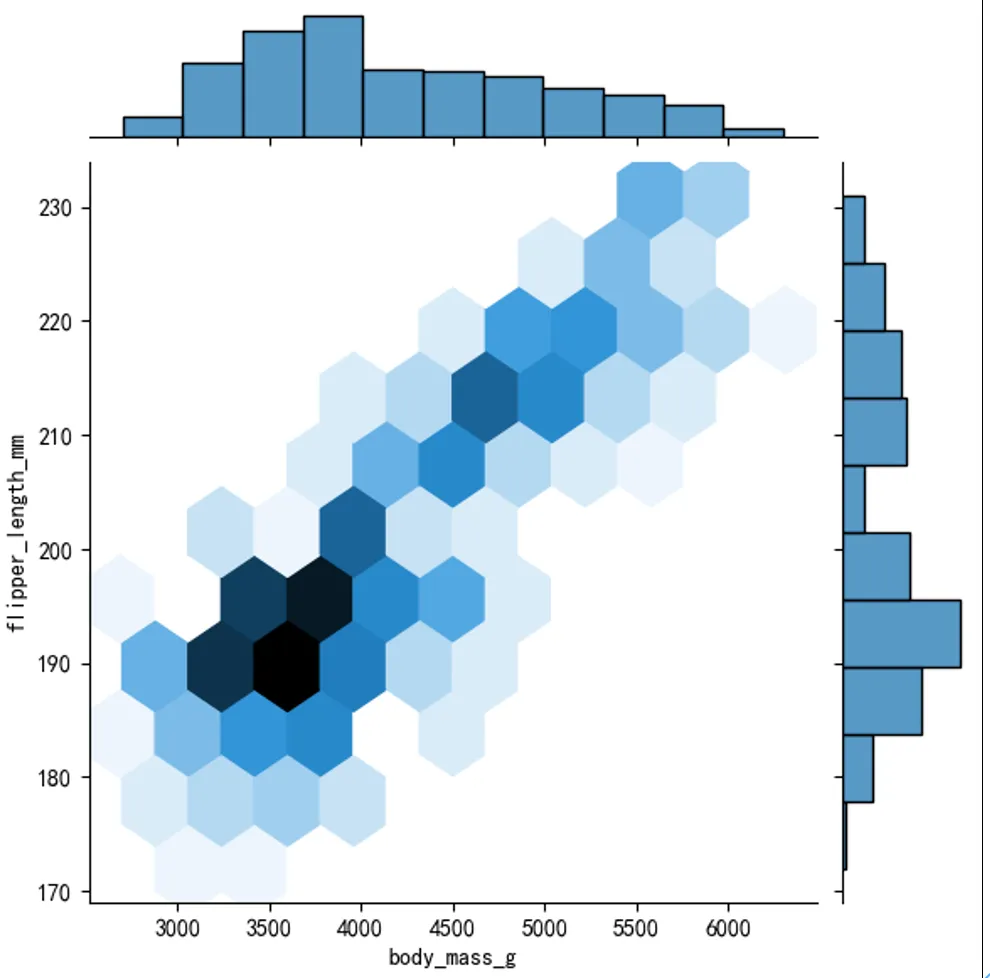
3)二维核密度估计图 通过kdeplot()函数,同时设置x参数和y参数来绘制二维核密度估计图。
sns.kdeplot(data=penguins, x="body_mass_g", y="flipper_length_mm")
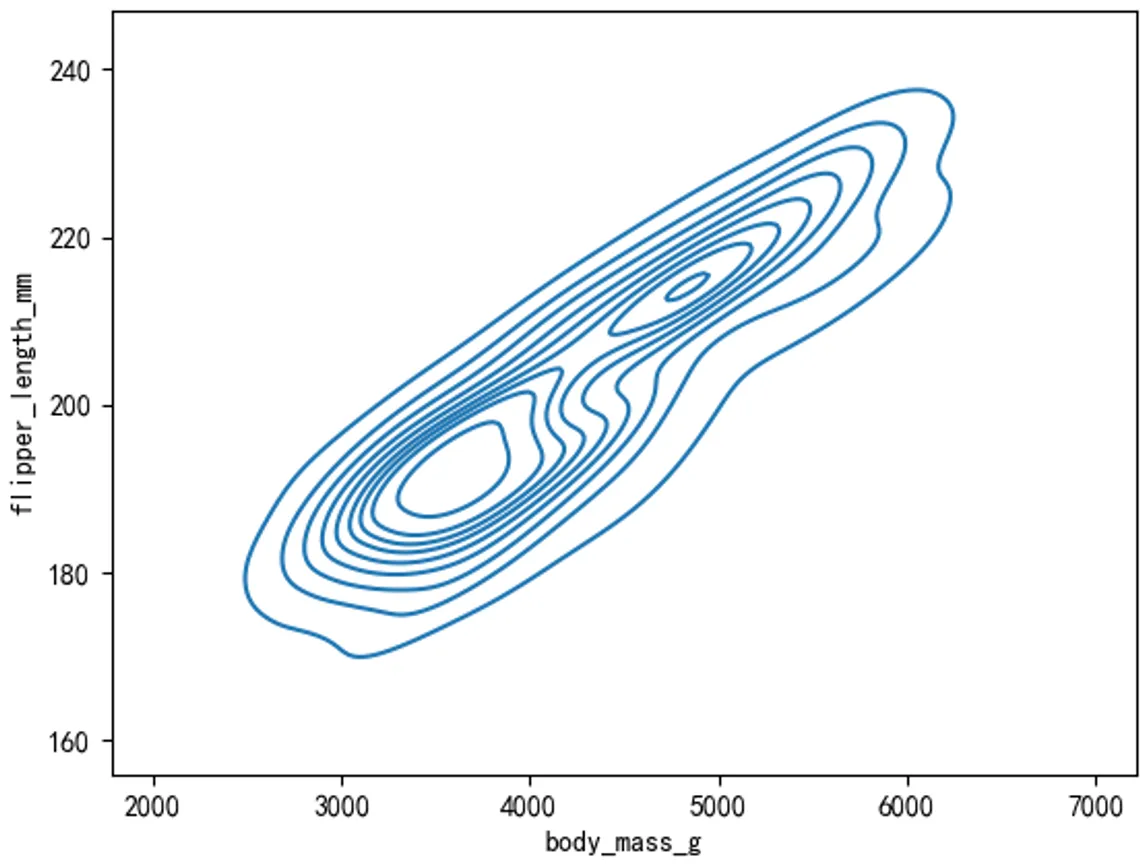
通过fill=True设置为填充,通过cbar=True设置显示颜色示意条。
sns.kdeplot(data=penguins, x="body_mass_g", y="flipper_length_mm", fill=True, cbar=True)
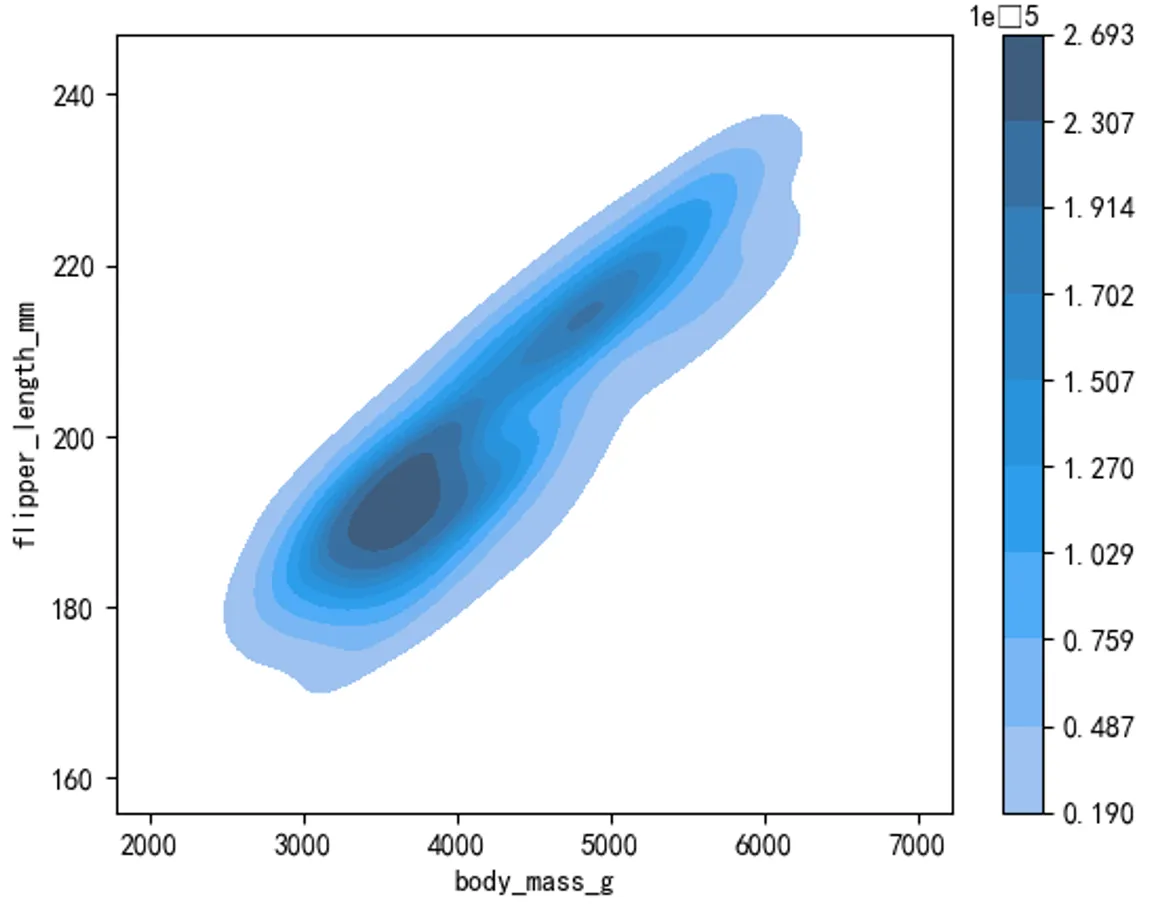
4)条形图 条形图会按x分组对y进行聚合,通过estimator参数设置聚合函数,并通过errorbar设置误差条,误差条默认会显示。可以通过误差条显示抽样数据统计结果的可能统计范围,如果数据不是抽样数据, 可以设置为None来关闭误差条。
sns.barplot(data=penguins, x="species", y="bill_length_mm", estimator="mean", errorbar=None)
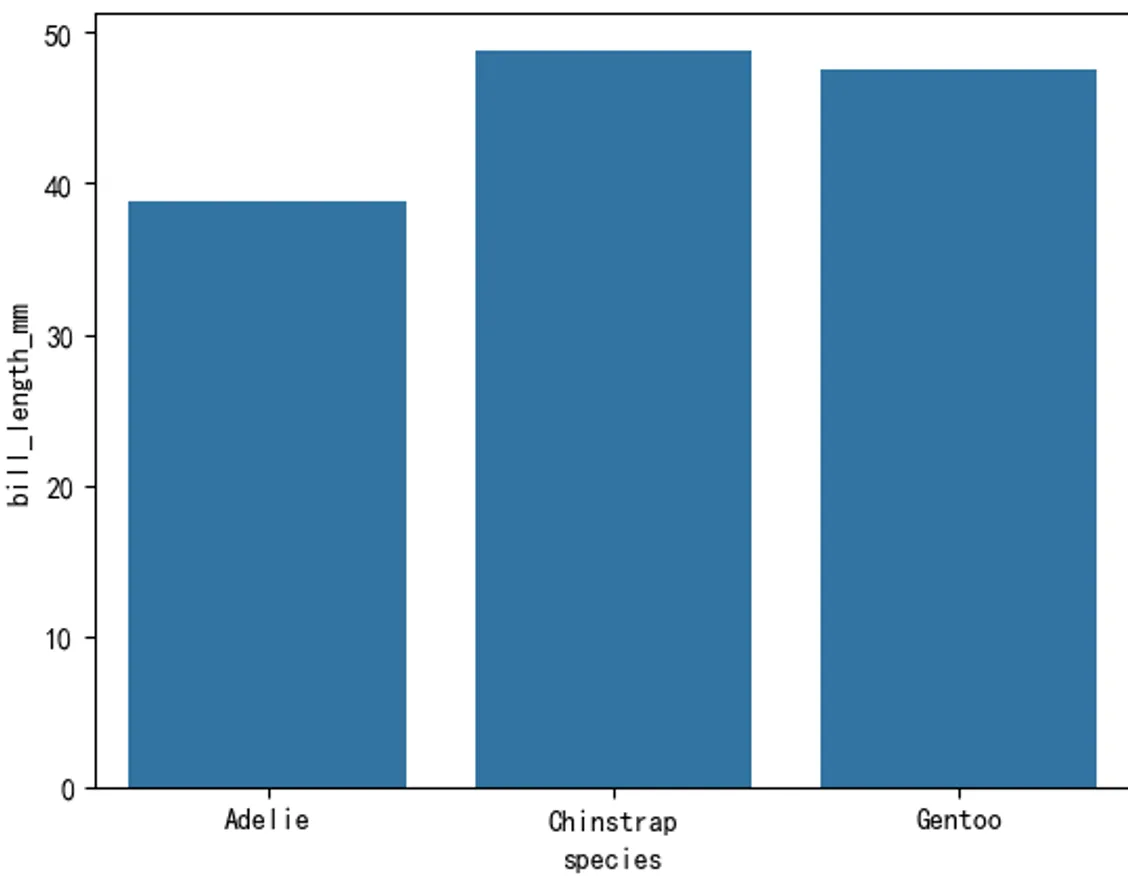
5)箱线图 箱线图是一种用于展示数据分布、集中趋势、散布情况以及异常值的统计图表。它通过五个关键的统计量(最小值、第一四分位数、中位数、第三四分位数、最大值)来展示数据的分布情况。 箱线图通过箱体和须来表现数据的分布,能够有效地显示数据的偏斜、分散性以及异常值。箱线图的组成部分:
- 箱体(Box):
- 下四分位数(Q1):数据集下 25% 的位置,箱体的下边缘。
- 上四分位数(Q3):数据集下 75% 的位置,箱体的上边缘。
- 四分位间距(IQR, Interquartile Range):Q3 和 Q1 之间的距离,用来衡量数据的离散程度。
- 中位数(Median):箱体内部的水平线,表示数据集的中位数。
- 须(Whiskers):
- 下须:从 Q1 向下延伸,通常是数据集中最小值与 Q1 的距离,直到没有超过1.5倍 IQR 的数据点为止。
- 上须:从 Q3 向上延伸,通常是数据集中最大值与 Q3 的距离,直到没有超过1.5倍 IQR 的数据点为止。
- 异常值(Outliers):
- 超过1.5倍 IQR 的数据被认为是异常值,通常用点标记出来。异常值是数据中相对于其他数据点而言“非常大”或“非常小”的值。
sns.boxplot(data=penguins, x="species", y="bill_length_mm")
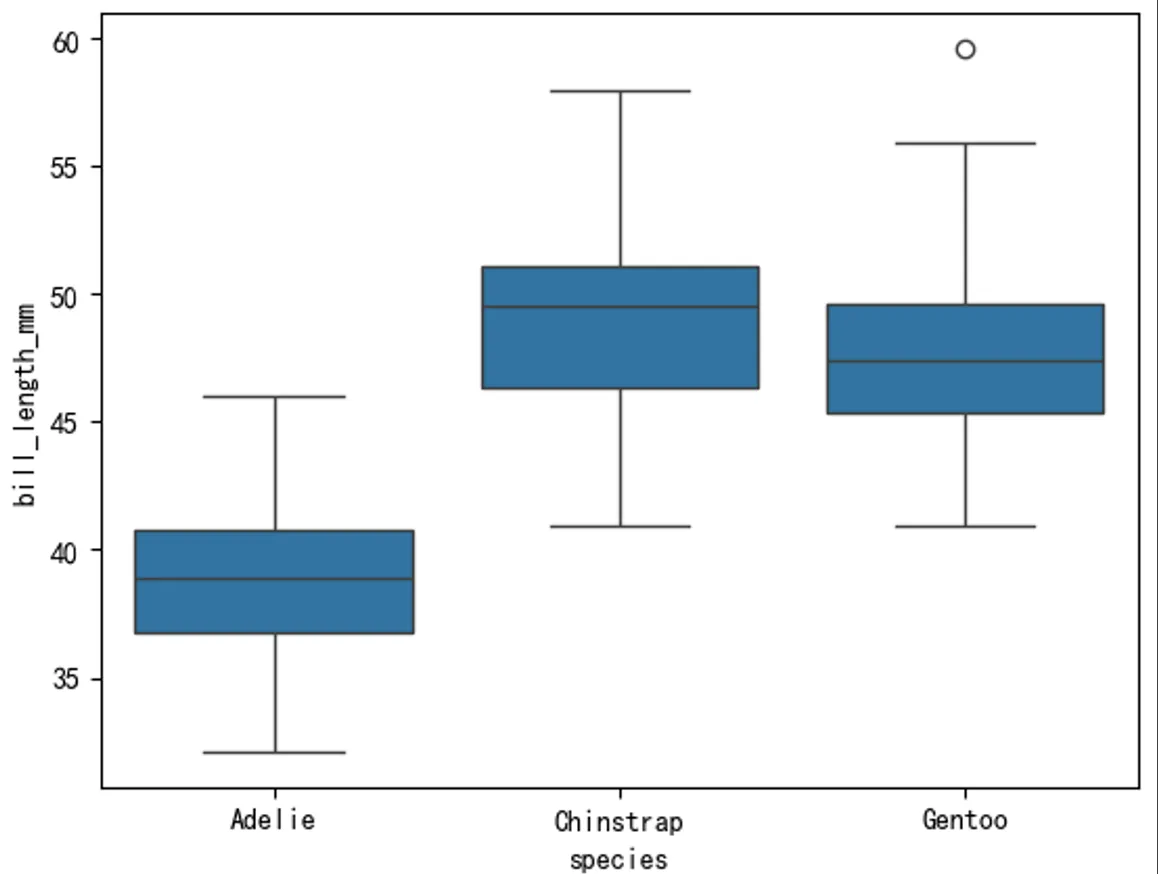
6)小提琴图 小提琴图(Violin Plot) 是一种结合了箱线图和核密度估计图(KDE)的可视化图表,用于展示数据的分布情况、集中趋势、散布情况以及异常值。小提琴图不仅可以显示数据的基本统计量(如中位数和四分位数),还可以展示数据的概率密度,提供比箱线图更丰富的信息。
sns.violinplot(data=penguins, x="species", y="bill_length_mm")
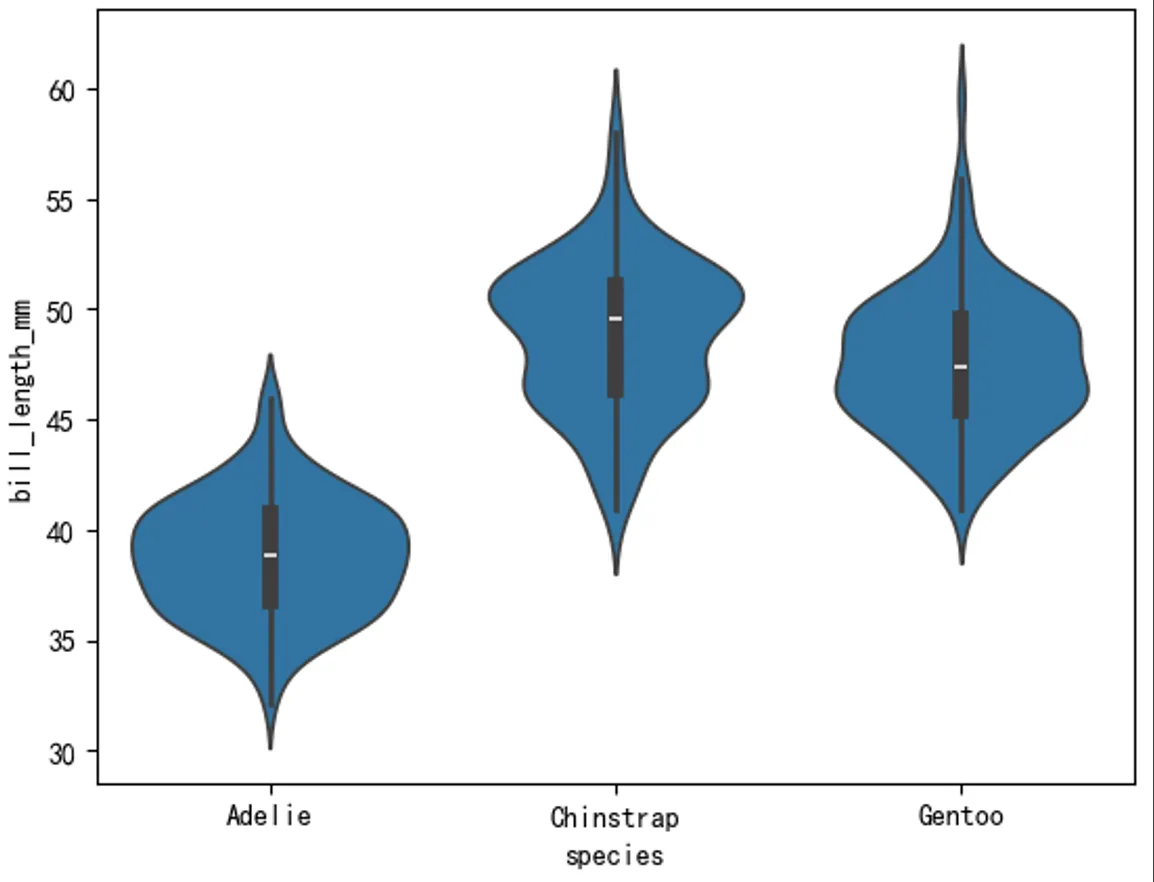
7)成对关系图 成对关系图是一种用于显示多个变量之间关系的可视化工具。它可以展示各个变量之间的成对关系,并且通过不同的图表形式帮助我们理解数据中各个变量之间的相互作用。 对角线上的图通常显示每个变量的分布(如直方图或核密度估计图),帮助观察每个变量的单变量特性。其他位置展示所有变量的两两关系,用散点图表示。
sns.pairplot(data=penguins, hue="species")
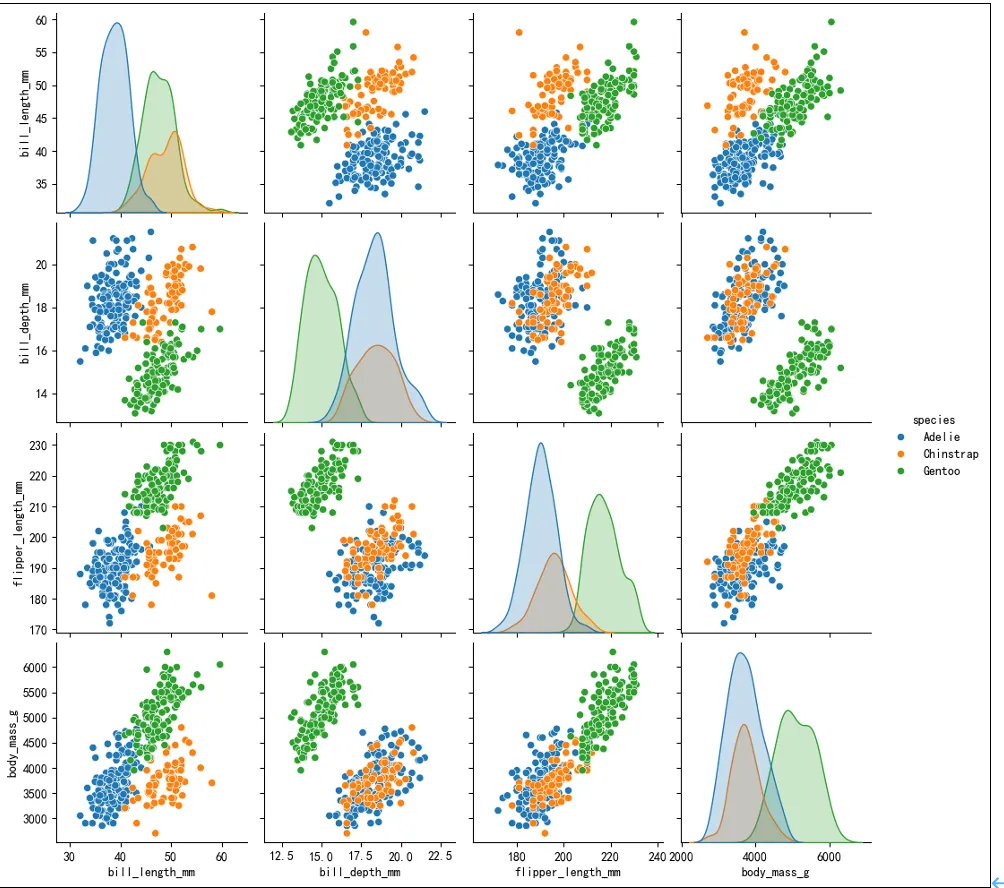
通常情况下成对关系图左上和右下对应位置的图的信息是相同的,可以通过PairGrid()为每个区域设置不同的图类型。
pair_grid = sns.PairGrid(data=penguins, hue="species")

# 通过 map 方法在网格上绘制不同的图形
pair_grid.map_upper(sns.scatterplot)  # 上三角部分使用散点图
pair_grid.map_lower(sns.kdeplot)  # 下三角部分使用核密度估计图
pair_grid.map_diag(sns.histplot)  # 对角线部分使用直方图
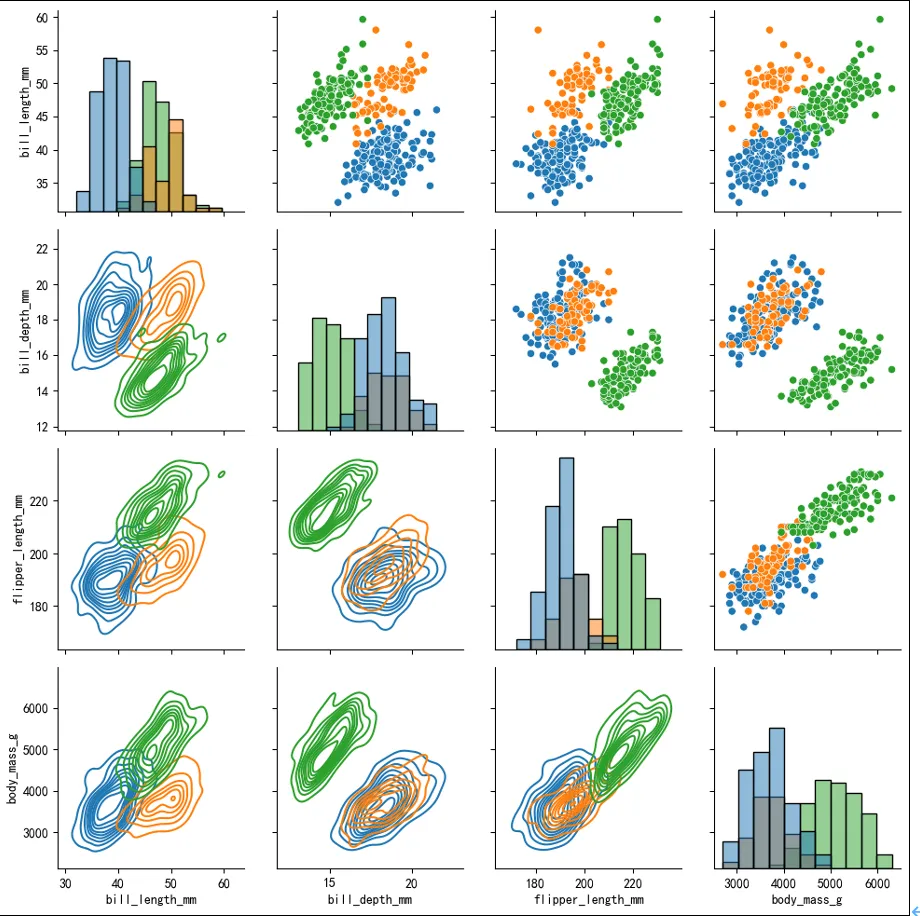
14.4 多变量可视化
多数绘图函数都支持使用hue参数设置一个类别变量,统计时按此类别分组统计并在绘图时使用颜色区分。 例如对小提琴图设置hue参数添加性别类别:
sns.violinplot(data=penguins, x="species", y="bill_length_mm", hue="sex", split=True)
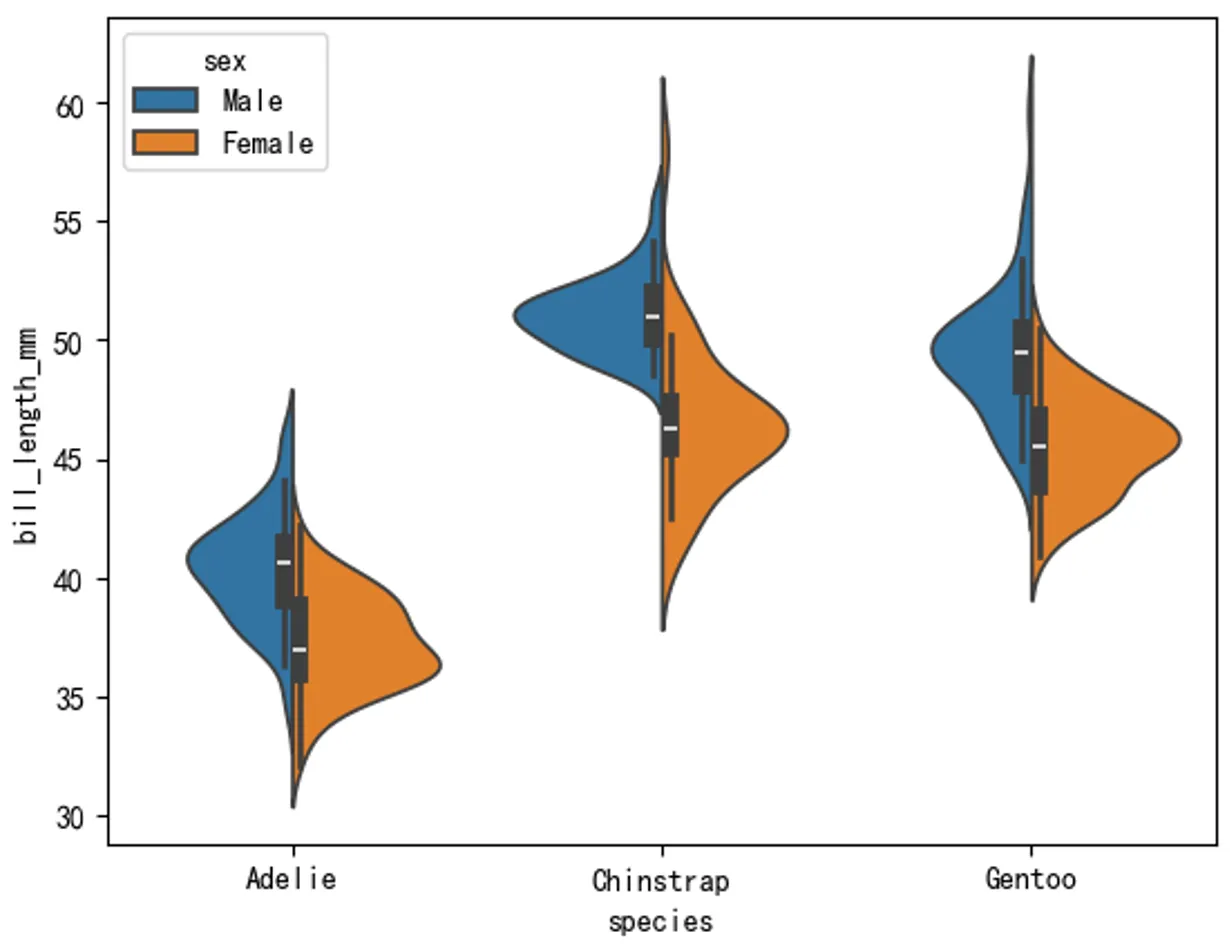
14.5 Seaborn样式
在Seaborn中,样式(style)控制了图表的整体外观,包括背景色、网格线、刻度线等元素。Seaborn提供了一些内置的样式选项,可以通过seaborn.set_style()来设置当前图表的样式。常见的样式有以下几种:
- white:纯白背景,没有网格线。
- dark:深色背景,带有网格线。
- whitegrid:白色背景,带有网格线。
- darkgrid:深色背景,带有网格线(默认样式)。
sns.set_style("darkgrid")
sns.histplot(data=penguins, x="island", kde=True)
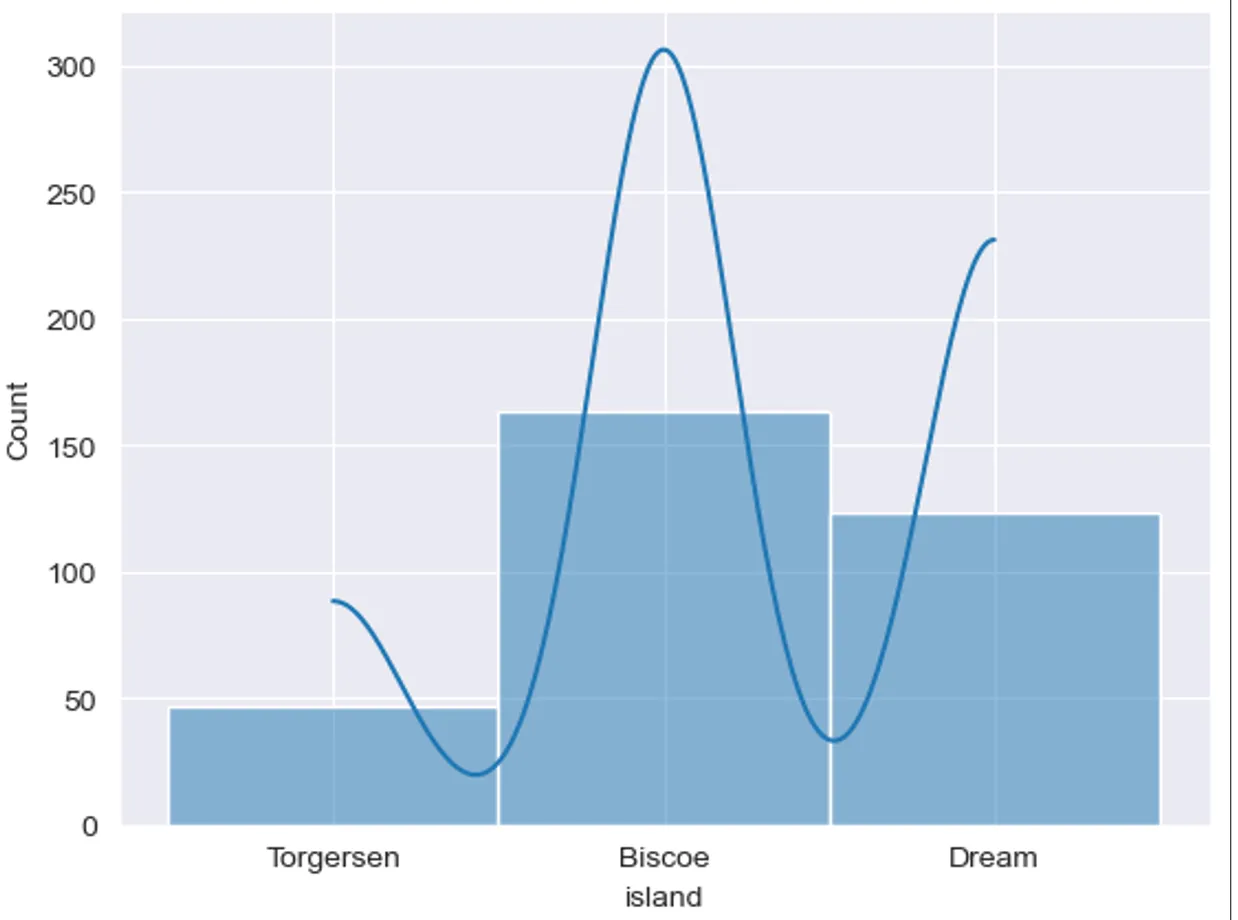

本文作者:繁星
本文链接:
版权声明:本博客所有文章除特别声明外,均采用 BY-NC-SA 许可协议。转载请注明出处!